Alcance y evidencia de la investigación
GEMM plantea una tensión útil para la ingeniería: la operación matemática es compacta, pero una implementación rápida depende de dónde reside cada operando, con qué frecuencia se mueve y cómo emite el procesador las operaciones aritméticas. Este artículo desarrolla esa relación desde una implementación escalar hasta la memoria gestionada explícitamente. Los modelos analíticos se deducen a continuación; no son mediciones de GAP8.
La investigación asociada es A BLIS-like matrix multiplication for machine learning in the RISC-V ISA-based GAP8 processor, en adelante R1. El trabajo se realizó en colaboración con Jie Lei, bajo la supervisión de Enrique Quintana y Adrián Castelló. El proyecto de investigación ofrece el estudio de caso de ingeniería más breve.
Se distinguen tres niveles de evidencia:
- Implementación publicada: el artículo de 2022 evalúa GEMM entero en el Fabric Controller (FC). Su SDK simulaba la operación de producto escalar vectorial; la presencia de una función auxiliar en el código no demuestra que se ejecutara una única instrucción de hardware R1, §§3–4.
- Implementación educativa portable: los ejemplos en C con FP32 ilustran la semántica y las transformaciones. Son código didáctico nuevo, no una reconstrucción del kernel de investigación ni un sustituto de BLAS para producción.
- Extensiones arquitectónicas: el solapamiento con DMA, el doble búfer y la descomposición multinúcleo que se presentan a continuación son propuestas para el análisis. El artículo identifica el solapamiento y la ejecución en el clúster como trabajo futuro R1, §5.
El repositorio público qblis_gpduino enlaza explícitamente el mismo DOI. Es evidencia relevante de la implementación, pero una instantánea actual no constituye automáticamente el artefacto exacto de un experimento histórico R2. Aquí no se afirma haber realizado nuevas pruebas de rendimiento ni mediciones de energía en GAP8.
Ver el proyecto de investigación · Descargar los ejemplos portables en C y sus pruebas
La multiplicación de matrices como grafo de dependencias
Partimos de la multiplicación ordinaria con valores reales:
M es el número de filas de salida, N el número de columnas de salida y K la dimensión interna compartida. Con índices que comienzan en cero, 0 ≤ i < M, 0 ≤ j < N y 0 ≤ k < K:
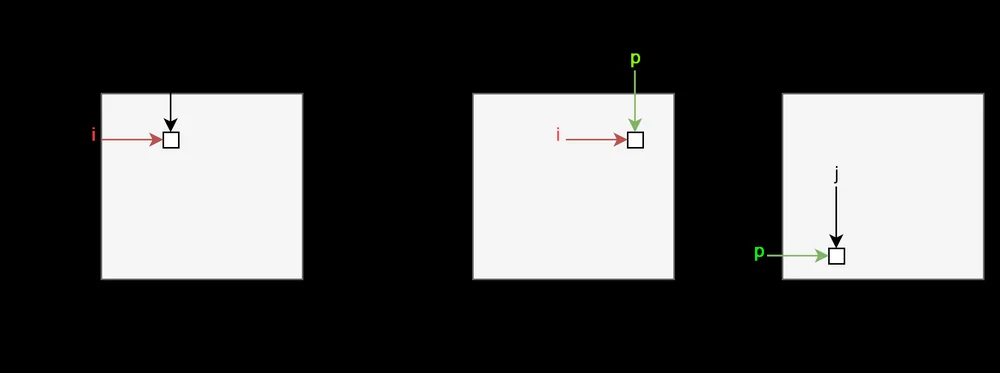
Cada elemento de salida depende de una fila de A y una columna de B. Multiplicar una matriz de 2 por 3 por otra de 3 por 2 produce un resultado de 2 por 2. El elemento C[1,0] utiliza A[1,0:3] y B[0:3,0]; no depende de otros elementos de salida. Sin embargo, sus tres productos deben combinarse antes de obtener su valor final.
Un producto escalar completa un elemento de salida utilizando toda la dimensión interna. Un producto matriz-vector calcula una columna de salida utilizando toda A con una columna de B. Un producto matriz-matriz procesa varias columnas conjuntamente, lo que permite utilizar un valor de A en varios elementos de salida. La interpretación mediante productos externos, en cambio, fija k:
Cada producto externo añade una contribución de rango uno. Un elemento de A puede servir para N actualizaciones, y uno de B para M actualizaciones. Son oportunidades de reutilización disponibles, no garantías de que un anidamiento de bucles las materialice en registros o caché.
Dimensiones compatibles
Producto escalar: un elemento
Producto externo: una contribución
La convolución puede expresarse mediante GEMM tras organizar los campos receptivos en una matriz. Materializar esa organización introduce tráfico de memoria y almacenamiento; mejorar GEMM no demuestra una aceleración equivalente de la convolución completa. Las capas completamente conectadas y los cálculos recurrentes también utilizan operaciones matriciales. La ilustración original de las dimensiones matriciales se conserva junto con estos nuevos diagramas explicativos.
El contrato de GEMM: más que tres dimensiones
La multiplicación general de matrices actualiza una salida existente:
Alfa escala el producto; beta escala la salida anterior. Las dimensiones lógicas de los operandos siguen siendo M por K y K por N después de aplicar op. Para operandos reales, op selecciona la matriz o su transpuesta. GEMM complejo distingue además la transpuesta conjugada R5.
Aplique beta una sola vez, no una vez por cada bloque de K. Con beta igual a cero, el resultado no debe depender de los valores iniciales de C. Si K o alfa es cero, la operación se reduce a escalar C. Si M o N es cero, no hay elementos de salida que modificar. Estos casos permiten detectar implementaciones por bloques incorrectas.
La disposición en memoria es independiente de las dimensiones matemáticas. En almacenamiento por filas, una dirección expresada en elementos es base + i*ld + j; la dimensión principal ld separa filas sucesivas. Para A, B y C sin transponer, debe permitir K, N y N elementos, respectivamente. El relleno puede hacerla mayor. Una submatriz conserva la dimensión principal de su matriz de origen; no pasa a ser compacta porque disminuya su anchura lógica.
En almacenamiento por columnas, la dirección es base + i + j*ld: la dimensión principal separa columnas. La convención de BLAS en Fortran es el almacenamiento por columnas. Una opción de transposición cambia la indexación lógica y las restricciones dimensionales; no exige transponer físicamente la memoria reservada. Tratar lda como M o K en todos los casos es un error habitual de interoperabilidad. Los pasos independientes entre filas y columnas describen vistas tensoriales más generales, pero los ejemplos portables admiten deliberadamente solo operandos por filas sin transponer.
Los ejemplos requieren que A, B y C no se solapen, que los tamaños de las reservas sean válidos y que los cálculos de tamaños y direcciones sean representables. No admiten solapamiento en el mismo espacio, vistas tensoriales arbitrarias ni entradas excepcionales generales de coma flotante. La interfaz de una biblioteca debe validar su contrato antes de despachar la operación, en lugar de permitir que los errores de disposición aparezcan como errores numéricos.
Trabajo aritmético, almacenamiento y comunicación
Para K positivo, un producto escalar reducido de forma independiente necesita K multiplicaciones y K−1 sumas. El recuento exacto del producto sin escalar bajo esta convención es:
La aproximación habitual cuenta acc += a*b como dos operaciones aritméticas. Una multiplicación-suma fusionada aporta dos operaciones de coma flotante bajo esa convención, aunque sea una instrucción con un único redondeo final. Aplicar alfa, beta y la suma final puede añadir aproximadamente tres operaciones por elemento de salida; los coeficientes especiales eliminan parte del trabajo. Indique si una tasa utiliza el trabajo útil convencional 2MNK o incluye ese epílogo.
Para FP32, la convención produce FLOP/s. Para multiplicación INT8 con acumulación entera, informe operaciones enteras/s. MAC/s cuenta una multiplicación-acumulación como una operación, mientras que la convención de dos operaciones la cuenta como dos. Un producto escalar empaquetado de cuatro vías aporta ocho operaciones enteras bajo esta última convención, no ocho FLOPs. Unifique estas definiciones antes de comparar implementaciones.
El cuerpo del bucle clásico se ejecuta MNK veces: trabajo cúbico para problemas cuadrados y proporcional a MNK en general. El almacenamiento residente de operandos y salida es proporcional a MK + KN + MN, mientras que una implementación escalar necesita un espacio auxiliar constante. El bloqueo y el empaquetado añaden organización y posiblemente espacio de trabajo; no reducen el recuento aritmético clásico.
La comunicación es un coste separado. Los registros pueden reutilizar operandos cargados; las líneas de caché pueden servir varios accesos; el DMA puede mover paneles contiguos. Las expresiones de carga del código fuente no equivalen a los bytes transferidos en todas las fronteras de memoria. Suponer que cada entrada cruza una vez y que C se lee y se escribe una vez da una estimación basada en la huella de los datos:
Los valores s son los bytes almacenados por elemento. Con beta igual a cero, un esquema controlado explícitamente puede omitir la lectura inicial de C. Esta estimación puede ser inalcanzable con memoria rápida limitada. La asignación de líneas por escritura, los paneles repetidos, el empaquetado y los volcados intermedios aumentan el tráfico. El diseño que evita comunicación pregunta qué valores pueden permanecer residentes durante más operaciones útiles, en lugar de limitarse a reducir instrucciones.
La representación numérica forma parte de la corrección
La representación cambia la demanda de ancho de banda, las instrucciones disponibles, la presión sobre los acumuladores y el resultado aceptable. FP32, FP16 y BF16 no son etiquetas de almacenamiento intercambiables. FP16 tiene un rango de exponentes menor que FP32; BF16 conserva un rango parecido al de FP32 con menos bits de significando. La conversión de las entradas pierde información. Que entradas de menor precisión se acumulen en FP32 es un contrato explícito del kernel, no una consecuencia de su tamaño de almacenamiento.
La suma en coma flotante no es asociativa. Las transformaciones de bucles, las reducciones vectoriales y las operaciones fusionadas pueden cambiar el redondeo aunque implementen la misma fórmula real. Una referencia de mayor precisión y una tolerancia absoluta más relativa son útiles, pero la cancelación vuelve poco fiable la comparación puramente relativa cerca de cero. Un diagnóstico más sólido también considera la magnitud de los productos que contribuyen al resultado. Registre las opciones de contracción y reasociación: -ffast-math cambia los supuestos numéricos que se permiten al compilador R8.
Para entradas INT8 con signo de rango completo, de −128 a 127, la mayor magnitud de un producto positivo es 16384. Un acumulador INT32 inicialmente cero tiene esta cota suficiente y conservadora:
Esto garantiza seguridad para entradas INT8 arbitrarias sin procesar, sin sesgo ni acumulación previa. No es un límite universal para redes cuantizadas: los valores iniciales del acumulador, la resta del punto cero, el sesgo y el reescalado cambian el margen de rango. En C, el desbordamiento de enteros con signo es comportamiento indefinido. El ejemplo entero adjunto acumula en INT64 y comprueba el rango INT32 antes de convertir; no demuestra una instrucción de GAP8.
La aritmética de punto fijo asocia un entero a una escala implícita. La multiplicación cambia esa escala, y la conversión de vuelta requiere un desplazamiento, una regla de redondeo y una política de rango especificados. La saturación recorta un resultado no representable y cambia la operación. No es un retorno modular ordinario ni una corrección exacta del desbordamiento.
Un modelo sencillo de cuantización afín es:
Aquí q es el entero almacenado, z el punto cero y s la escala. Los productos de enteros centrados aproximan productos reales después del reescalado. La especificación de LiteRT aporta un contrato concreto de un entorno de ejecución R7; no debe imponerse de forma implícita a esta investigación histórica. La cuantización introduce aproximación y posiblemente recorte. El sesgo, la corrección del punto cero, la recuantización y el recorte de activaciones son trabajo adicional ausente de GEMM entero básico.
La corrección del kernel y la exactitud de la aplicación son requisitos distintos: calcular exactamente la operación entera declarada no demuestra que la aplicación cuantizada alcance su objetivo de exactitud. A la inversa, un pequeño error en la aplicación no justifica un desbordamiento indefinido dentro del kernel.
Algoritmos 1–2: GEMM ingenuo y reordenación de bucles
Ejemplo portable en C. El paquete descargable aporta declaraciones, funciones auxiliares de validación y escalado, y órdenes de compilación. Los tres kernels FP32 aceptan M, N, K y dimensiones principales con relleno; las entradas se almacenan por filas, sin transponer y sin solaparse. Implementan la semántica alfa/beta para entradas finitas cuyos productos y acumulaciones intermedios siguen siendo representables en FP32. El artículo incluye el código fuente exacto que compilan las pruebas.
/* Portable C: FP32 row-major, i-j-k order; helpers are in gemm.c. */
int gemm_naive(size_t m, size_t n, size_t k, float alpha,
               const float *a, size_t lda, const float *b, size_t ldb,
               float beta, float *c, size_t ldc) {
    int status = gemm_validate(m, n, k, alpha, a, lda, b, ldb, c, ldc);
    if (status != GEMM_OK || m == 0 || n == 0) return status;
    if (alpha == 0.0f || k == 0) {
        gemm_scale(m, n, beta, c, ldc);
        return GEMM_OK;
    }
    for (size_t i = 0; i < m; ++i) {
        for (size_t j = 0; j < n; ++j) {
            float sum = 0.0f;
            for (size_t p = 0; p < k; ++p)
                sum += a[i * lda + p] * b[p * ldb + j];
            float old_c = beta == 0.0f ? 0.0f : beta * c[i * ldc + j];
            c[i * ldc + j] = alpha * sum + old_c;
        }
    }
    return GEMM_OK;
}
El orden i-j-k completa un elemento de salida cada vez. La fila de A es contigua, pero los valores sucesivos de B están separados por ldb elementos. A puede recorrerse de nuevo para cada columna de salida. Que esos accesos acierten en caché depende de la capacidad, la asociatividad y los demás datos activos. Un acumulador escalar evita almacenar repetidamente la suma parcial de ese producto escalar.
Cambiar a i-k-j expone filas contiguas de B y C:
/* Portable C: FP32 row-major, i-k-j order; helpers are in gemm.c. */
int gemm_reordered(size_t m, size_t n, size_t k, float alpha,
                   const float *a, size_t lda, const float *b, size_t ldb,
                   float beta, float *c, size_t ldc) {
    int status = gemm_validate(m, n, k, alpha, a, lda, b, ldb, c, ldc);
    if (status != GEMM_OK || m == 0 || n == 0) return status;
    gemm_scale(m, n, beta, c, ldc);  /* Scale C exactly once. */
    if (alpha == 0.0f || k == 0) return GEMM_OK;
    for (size_t i = 0; i < m; ++i) {
        for (size_t p = 0; p < k; ++p) {
            float scaled_a = alpha * a[i * lda + p];
            for (size_t j = 0; j < n; ++j)
                c[i * ldc + j] += scaled_a * b[p * ldb + j];
        }
    }
    return GEMM_OK;
}
Para un (i,k) fijo, un valor escalado de A sirve a N elementos de salida. Los accesos contiguos a B/C pueden facilitar la vectorización, pero C se actualiza repetidamente a lo largo de k. Si la fila de salida no puede permanecer en caché, ese tráfico puede superar la ventaja del mejor acceso a B. Aplicar alfa dentro de la reducción también cambia el redondeo respecto a escalar el producto escalar ya completado; las pruebas utilizan una tolerancia declarada, no igualdad bit a bit.
El orden k-i-j reutiliza una fila de B entre filas de salida, pero vuelve a recorrer una parte mayor de C para cada k. Puede ayudar si ese conjunto de trabajo de salida permanece residente y perjudicar cuando no lo hace. El almacenamiento por columnas cambia qué recorrido es contiguo. No existe una permutación universalmente mejor que sea independiente de la disposición y la jerarquía.
Un compilador puede desenrollar, vectorizar, adelantar cargas o fusionar multiplicaciones y sumas, sujeto a las reglas numéricas y de aliasing. El análisis del código fuente predice oportunidades, no recuentos exactos de cargas ejecutadas. Examine los diagnósticos de optimización y el ensamblador antes de atribuir un resultado a una secuencia concreta de instrucciones. Ambas variantes conservan aritmética proporcional a MNK y espacio auxiliar constante.
Algoritmo 3: bloqueo para un conjunto de trabajo acotado
El bloqueo limita la parte de A, B y C que se reutiliza a la vez. Un bloque de salida contiene como máximo BM filas y BN columnas; cada panel de reducción contiene como máximo BK elementos internos. Para el bloque de filas I, el de columnas J y el interno P:
Recorte los bloques finales a las dimensiones restantes. Beta debe aplicarse fuera de la suma sobre paneles de K. Una estimación de capacidad para los bloques simultáneos es:
Ejemplo portable en C. Este kernel escala C una vez y después aplica bloqueo con tratamiento de bordes. BM, BN y BK deben ser positivos. Utiliza almacenamiento y acumulación FP32, sin empaquetado ni DMA explícito.
/* Portable C: FP32 row-major; bm/bn/bk must be nonzero. */
int gemm_blocked(size_t m, size_t n, size_t k, float alpha,
                 const float *a, size_t lda, const float *b, size_t ldb,
                 float beta, float *c, size_t ldc,
                 size_t bm, size_t bn, size_t bk) {
    if (bm == 0 || bn == 0 || bk == 0) return GEMM_INVALID;
    int status = gemm_validate(m, n, k, alpha, a, lda, b, ldb, c, ldc);
    if (status != GEMM_OK || m == 0 || n == 0) return status;
    gemm_scale(m, n, beta, c, ldc);
    if (alpha == 0.0f || k == 0) return GEMM_OK;
    for (size_t ii = 0; ii < m;) {
        size_t i_end = gemm_edge(ii, bm, m);
        for (size_t jj = 0; jj < n;) {
            size_t j_end = gemm_edge(jj, bn, n);
            for (size_t pp = 0; pp < k;) {
                size_t p_end = gemm_edge(pp, bk, k);
                for (size_t i = ii; i < i_end; ++i)
                    for (size_t p = pp; p < p_end; ++p) {
                        float scaled_a = alpha * a[i * lda + p];
                        for (size_t j = jj; j < j_end; ++j)
                            c[i * ldc + j] += scaled_a * b[p * ldb + j];
                    }
                pp = p_end;
            }
            jj = j_end;
        }
        ii = i_end;
    }
    return GEMM_OK;
}
La localidad espacial consiste en recorrer elementos adyacentes. La localidad temporal consiste en reutilizar un valor antes de su expulsión. El bloqueo intenta compatibilizar ambas con una memoria rápida limitada. BM y BN controlan cuántos elementos de salida comparten cada panel de entrada; BK controla la longitud del panel de reducción y la granularidad de transferencia. Un BK mayor consume capacidad que podría alojar un bloque de salida más ancho, sin aumentar necesariamente la reutilización entre elementos de salida.
Una desigualdad de capacidad es necesaria, pero insuficiente, en CPU con caché: los conflictos entre conjuntos, el comportamiento de las líneas, el alcance de la TLB y otros datos vivos reducen la capacidad útil. En una memoria scratchpad se convierte en una restricción de reserva explícita, con espacio separado para pilas y datos del entorno de ejecución. La alineación puede mejorar las cargas vectoriales o el DMA, pero el relleno añade bytes que deben contabilizarse.
Para una salida de 7 por 11 con K=5, BM=4, BN=6 y BK=3, todos los ejes tienen un bloque parcial. Leer un bloque nominal completo fuera de su reserva es inválido aunque se descarten los productos adicionales. Implemente límites recortados o copias con relleno y almacenamiento válido. Las pruebas incluyen estos casos, parámetros de bloque sobredimensionados y dimensiones principales con relleno.
El bloqueo añade sobrecarga de control y decisiones de ajuste. Las matrices diminutas quizá ya quepan; las muy alargadas ofrecen reutilización limitada en una dirección. El ejemplo explica una transformación sin afirmar que logre rendimiento óptimo en CPU. La aritmética sigue siendo proporcional a MNK y el espacio auxiliar permanece constante porque esta versión no reserva búferes de bloques separados.
B almacenada por filas
Bloques compatibles
Jerarquía lógica tipo BLIS
Algoritmo 4: empaquetar operandos para el consumidor
El empaquetado copia un panel con pasos de memoria en una disposición elegida para su microkernel. Un posible formato de A almacena un segmento de columna de MR elementos para cada k; un posible formato de B almacena un segmento de fila de NR elementos por k. El consumidor lee entonces secuencias compactas en lugar de tratar repetidamente pasos arbitrarios del origen. Son formatos de ejemplo; el empaquetador y el consumidor deben coincidir exactamente.
Las cargas regulares, una alineación conocida y una aritmética de direcciones más sencilla pueden mejorar el bucle interno. El empaquetado puede incorporar transposición o relleno. Los elementos de relleno necesitan la representación neutra correcta: para un valor cuantizado afín, el cero real puede requerir el entero del punto cero en lugar de un patrón de bits cero.
Copiar E elementos de tamaño s tiene una estimación sencilla de copia explícita de 2sE bytes: una lectura y una escritura a través de las interfaces de origen y destino. Esto no es necesariamente tráfico de DRAM: esas interfaces pueden estar en distintos niveles de la jerarquía. El kernel de cómputo también lee después el panel empaquetado. Cuantifique ambas implementaciones en la misma frontera antes de afirmar una reducción del tráfico.
La amortización determina si el empaquetado ayuda. Un panel de B consumido por muchos paneles de A puede compensar repetidamente su copia. Para una única matriz diminuta, la reserva y la copia pueden dominar. Preempaquetar pesos constantes desplaza el coste fuera de las llamadas repetidas de inferencia, pero consume memoria persistente y exige invalidación cuando cambian los pesos o el formato de empaquetado.
Indique los requisitos de alineación tanto de los pasos entre paneles sucesivos como de la primera dirección. Rellenar K hasta un múltiplo del ancho SIMD puede aumentar la aritmética ejecutada si no se suprime el tratamiento de la cola. Informe las operaciones útiles por separado de las de relleno. El empaquetado añade espacio de trabajo proporcional a los paneles seleccionados y una pasada adicional por su contenido; es una optimización con un umbral de amortización, no un paso obligatorio para todo GEMM.
Algoritmo 5: macro-kernel y microkernel de tipo BLIS
BLIS separa la organización reutilizable de los kernels específicos de la arquitectura R3. Su microkernel GEMM documentado consume operandos empaquetados y actualiza un pequeño bloque de salida R4. La siguiente organización educativa no es una transcripción de BLIS ni de la implementación para GAP8.
Pseudocódigo independiente de la arquitectura. Los operandos son conceptualmente FP32 y se almacenan por filas antes del empaquetado, con dimensiones M/N/K y tamaños de borde recortados. El espacio de empaquetado es proporcional a MC*KC + KC*NC; el bloque de registros es MR*NR. Los búferes no se solapan.
if M == 0 or N == 0: return
if alpha == 0 or K == 0:
    scale_C_by_beta(); return
for jc in blocks(N, NC):
    for pc in blocks(K, KC):
        Bp = pack_B(B[pc, jc], actual_KC, actual_NC)
        for ic in blocks(M, MC):
            Ap = pack_A(A[ic, pc], actual_MC, actual_KC)
            for jr in blocks(actual_NC, NR):
                for ir in blocks(actual_MC, MR):
                    beta_panel = beta if pc == 0 else 1
                    microkernel(actual_MR, actual_NR, actual_KC,
                                alpha, Ap[ir], Bp[jr], beta_panel,
                                C[ic + ir, jc + jr], ldc)
En el microkernel, inicialice acumuladores de MR por NR, recorra las entradas empaquetadas a lo largo de KC y añada las contribuciones de productos externos a los registros. Después de la reducción, combine con C mediante alfa/beta y almacene el resultado. Los acumuladores independientes exponen paralelismo entre instrucciones y evitan escribir en memoria cada suma parcial.
MR y NR dependen de la capacidad de registros y la disposición de las instrucciones. Más acumuladores pueden ocultar latencia, pero una presión excesiva vuelca valores a memoria y frustra la reutilización. Los registros de entrada, los punteros y el estado del bucle también consumen recursos. El mejor bloque de registros no es simplemente el mayor conjunto de acumuladores que parezca caber.
El macro-kernel elige qué panel empaquetado se reutiliza en cada nivel. La mayor parte de la organización puede seguir siendo portable mientras un microkernel especializado se ocupa de la disposición de registros y la planificación. La investigación de GAP8 adapta principios de tipo BLIS a la aritmética entera y al movimiento explícito de memoria R1; no implica que un binario BLIS convencional para CPU se ejecute sin cambios en GAP8.
En la revisión 53f8bc6187470a435c501fbfb6ef58267c431b75, gemm_blis_B3C2A0 empaqueta B en memoria externa, lleva un micropanel de B a través de L2 hasta la TCDM del FC, mantiene un bloque de C en L2 y consume un microbloque de A en registros con datos empaquetados R2. Esta ubicación difiere del pseudocódigo educativo anterior, que conserva C en registros; los párrafos comparativos del artículo también alternan nombres de variantes, por lo que describir la ubicación resulta más seguro. La configuración versionada S_CHART almacena C mediante tipos signed char; los ejemplos educativos con acumuladores más anchos no deben atribuirse a ese código.
El empaquetado, la planificación del macro-kernel y el ajuste de instrucciones resuelven problemas distintos. Acelerar el kernel interno puede revelar un cuello de botella en el empaquetado. Ampliar los paneles puede reducir la frecuencia de empaquetado y, a la vez, agotar la memoria local. Mida los componentes y la operación completa antes de decidir dónde introducir otra transformación.
Jerarquía de memoria y arquitectura de GAP8
Los registros contienen los operandos y acumuladores inmediatamente activos. Una CPU con caché carga y expulsa automáticamente líneas de caché de datos; el software influye en ese comportamiento mediante sus patrones de acceso. Una memoria scratchpad expone almacenamiento que el software reserva y llena. Ambas tienen límites de latencia, ancho de banda y capacidad, pero distintas obligaciones de corrección: el hardware resuelve una línea ausente en caché, mientras que consumir un bloque scratchpad antes de completar su transferencia lee datos obsoletos o no disponibles.
Por tanto, un anidamiento de bucles favorable para caché es incompleto para una memoria scratchpad: también necesita reglas de ubicación, transferencia, sincronización y vida útil. A la inversa, copiar manualmente todos los bloques en un sistema con caché puede añadir tráfico sin mejorar la reutilización. Identifique la interfaz limitada en lugar de considerar universalmente superior una de las políticas de gestión.
El manual oficial de GAP8 distingue el Fabric Controller del clúster de cómputo de ocho núcleos, incluidos sus contextos de memoria local. El clúster tiene almacenamiento L1 compartido en bancos, L2 es un nivel de mayor capacidad dentro del chip y el DMA permite movimiento explícito R6. La contención en bancos compartidos puede serializar accesos incluso cuando los datos caben. GAP8 tiene cachés de instrucciones; describir su memoria de datos gestionada por software no significa que el chip carezca de cualquier tipo de caché.
Objetivo publicado en 2022: FC
Clúster: contexto arquitectónico
La implementación de 2022 se dirige al FC, no a ocho núcleos del clúster ejecutándose simultáneamente R1, §3. No pueden asignarse a ese experimento la capacidad ni el rendimiento agregado del clúster. El diagrama es estructural, no un mapa de reservas del kernel publicado. Del mismo modo, que el chip se oriente al bajo consumo no demuestra que cada transformación ahorre energía.
La memoria externa crea otra frontera cuando la configuración de la placa la incluye. Su ancho de banda no puede sustituir al de L2 a memoria local. La reproducibilidad requiere especificar placa y memoria, ubicación en FC o clúster y localización del código, los operandos y los búferes empaquetados. El nombre del procesador por sí solo deja sin especificar condiciones esenciales.
Presupuesto de bloques y almacenamiento auxiliar
Para un bloque de salida residente en memoria local y un conjunto de búferes de entrada, sea s_acc el tamaño del acumulador. Sea W_pack únicamente el almacenamiento de empaquetado adicional a los búferes de entrada:
Reserve pilas, descriptores, huecos de alineación y datos del entorno de ejecución en W_aux. Si los búferes de entrada ya están empaquetados, cuéntelos una sola vez, sin añadir otra reserva idéntica para empaquetado. Si C almacenada y su acumulador tienen representaciones distintas, cuente también cualquier búfer de entrada o salida residente por separado.
El doble búfer para ambas entradas da:
Ajuste el presupuesto pertinente a la memoria local disponible, no a su capacidad nominal. Estos modelos suponen un bloque de acumuladores y ninguna salida con doble búfer. Un bloque menor impuesto por W2 puede perder suficiente reutilización para anular el solapamiento. Por ello, la planificación de búferes y la selección de bloques deben diseñarse conjuntamente.
Algoritmo 6: SIMD y productos escalares empaquetados
SIMD procesa varias vías por operación. Un producto escalar empaquetado multiplica vías correspondientes y las reduce a un acumulador. La ventaja depende de alimentar las vías, ocultar la latencia de las dependencias y conservar la semántica de signo y rango. Empaquetar valores INT8 en una palabra es una decisión de disposición; seleccionar la instrucción deseada es una cuestión distinta de la cadena de herramientas.
Varios acumuladores independientes pueden intercalar cadenas de dependencias. El desenrollado reduce la sobrecarga de saltos, pero aumenta la presión sobre los registros y el tamaño del código. Las entradas desalineadas, las colas cortas de K y las instrucciones de conversión pueden reducir la ganancia. El tratamiento de colas debe evitar lecturas fuera de la reserva, incluso si esta termina en una página inaccesible.
El fabricante documenta la aritmética empaquetada de GAP8 R6, pero el artículo describe simulación de las operaciones de producto escalar por el SDK en la configuración evaluada R1. El SDK oficial también contiene rutas con funciones intrínsecas del objetivo y emulación escalar para gap8_dotp4 R10. Ni el nombre de una función auxiliar ni un tipo vectorial de C demuestran qué ruta ejecutó un binario histórico. Conserve las opciones del compilador y la ISA y el desensamblado del bucle crítico para respaldar una futura afirmación sobre instrucciones nativas.
Los ejemplos FP32 dependen del compilador del equipo anfitrión, no solicitan intrínsecos de GAP8 y no demuestran aceleración SIMD entera. Su función es validar la semántica y las transformaciones antes de introducir selección específica de la arquitectura. El código didáctico INT8 con acumulador más ancho es un ejemplo de corrección; no debe confundirse con la disposición de acumuladores del repositorio histórico.
Algoritmo 7: GEMM consciente del DMA
Optimización conceptual. Considere un bloque de salida residente, bloques A/B INT8 y un acumulador INT32 con un rango seguro demostrado. El DMA transfiere desde memoria más lenta a búferes locales; el cómputo consume únicamente transferencias completadas. Este es pseudocódigo independiente de la arquitectura, no código verificado del SDK de GAP8:
initialize output accumulator using the declared beta semantics
for p in inner_dimension_tiles:
    shape = clipped_shape(p, M, N, K, BM, BN, BK)
    a_event = dma_load_A(A, local_A, shape)
    b_event = dma_load_B(B, local_B, shape)
    wait(a_event); wait(b_event)
    make_completed_writes_visible_to_compute()
    accumulate_tile(local_A, local_B, accumulator, shape)
apply declared scaling / conversion; store output tile
wait for output store before reusing its source storage
La inicialización y la conversión final deben coincidir con el contrato entero real. Un kernel INT8 no admite automáticamente alfa/beta reales arbitrarios. Una extensión de coma flotante, en cambio, carga y escala C con acumuladores de coma flotante. La aritmética del bloque sigue siendo proporcional a BMBNBK; los costes de transferencia y sincronización son adicionales.
El DMA puede imponer restricciones de alineación, granularidad y pasos de memoria. Un bloque con pasos necesita un descriptor bidimensional o varias transferencias por filas. Un primer modelo útil de transferencia es:
n_desc cuenta descriptores, tau es el coste efectivo de preparación y lanzamiento, y Q los bytes transferidos. Son parámetros que deben medirse. Los bloques grandes amortizan la preparación, pero consumen capacidad. Dos transferencias de entrada pueden compartir un motor o bus, de modo que sus tiempos no son necesariamente independientes.
Esta planificación con un único búfer serializa carga y cómputo. Es una referencia útil con propiedad claramente definida. El empaquetado sigue siendo una fase separada: si lo realiza el núcleo de cómputo, llamarlo parte de la transferencia no hace que se solape con la aritmética. La finalización de la salida también importa antes de reutilizar su almacenamiento o terminar la medición.
Algoritmo 8: doble búfer con propiedad explícita
Extensión arquitectónica, no un resultado verificado del estudio de 2022. Reserve dos conjuntos de búferes de entrada. El DMA llena uno mientras el cómputo consume el otro, siempre que recursos independientes permitan el solapamiento. Esta planificación hipotética trata cero, uno, cantidades impares y bloques parciales. Supone eventos fiables de finalización y visibilidad, entradas INT8, acumulación INT32 segura y un bloque de salida residente.
initialize_output_accumulator_using_declared_beta_semantics()
if tile_count == 0:
    finalize_and_store_output()
    wait_for_output_store()
    return

for b in {0, 1}: state[b] = FREE
event[0] = launch_both_inputs(tile=0, buffer=0, clipped_shape(0))
state[0] = LOADING

for t in 0 .. tile_count-1:
    cur = t mod 2
    nxt = 1 - cur
    wait_all(event[cur])
    make_completed_writes_visible_to_compute()
    state[cur] = READY

    if t + 1 < tile_count:
        assert state[nxt] == FREE
        event[nxt] = launch_both_inputs(t + 1, nxt, clipped_shape(t + 1))
        state[nxt] = LOADING

    state[cur] = COMPUTING
    accumulate_tile(buffer[cur], accumulator, clipped_shape(t))
    wait_for_any_async_compute_reads_to_finish()
    state[cur] = FREE

finalize_and_store_output()
wait_for_output_store()
La primera carga precede al cómputo. La reutilización solo ocurre cuando termina el consumidor anterior. Cada iteración espera ambas entradas y lanza la siguiente transferencia únicamente si existe; la última iteración no puede acceder a un bloque fuera de rango. Las cantidades impares no requieren una regla especial de precarga insegura: la paridad solo selecciona un búfer.
Si un trabajador o acelerador consume de forma asíncrona, su finalización determina cuándo queda libre un búfer, no el retorno del núcleo que emitió la operación. La espera explícita del cómputo cubre ese caso. Implemente la visibilidad, las barreras de memoria y la vida útil de los eventos según el entorno real; la API abstracta no es una receta del SDK. C sigue siendo propiedad del cómputo hasta completar su almacenamiento final. Estas reglas evitan que el DMA sobrescriba entradas todavía en uso.
Un conjunto de búferes de entrada
Dos conjuntos: A y B
Para L bloques uniformes, tiempo de transferencia D y tiempo de cómputo G, una planificación de entrada con un único búfer tarda L(D+G). Con recursos independientes y sincronización despreciable:
El arranque D y el cómputo final G no tienen una fase vecina que los oculte. El intervalo en régimen estacionario se aproxima a:
Este modelo optimista excluye movimiento de salida, bordes no uniformes, empaquetado y sincronización. El DMA y la aritmética pueden competir por los bancos, aumentando D y G durante el solapamiento. Un único bloque no ofrece solapamiento entre bloques; las transferencias pequeñas pueden estar limitadas por el lanzamiento, y los búferes adicionales pueden obligar a usar un bloqueo peor. El doble búfer solo ayuda si la latencia oculta supera estos costes adicionales.
GEMM paralelo: particionar salidas antes que reducciones
Extensión multinúcleo conceptual. Asigne bloques disjuntos de C a los trabajadores. Cada uno realiza su reducción completa en K, aplica beta una vez y es propietario de sus escrituras. Esto evita escrituras concurrentes de salida y reducciones entre núcleos. Un panel compartido de B puede servir a varios trabajadores si se protege su vida útil hasta que termine cada consumidor.
Dividir K produce varias salidas parciales para el mismo bloque de C. Requiere acumuladores privados o actualizaciones sincronizadas y una reducción final. Esto añade almacenamiento, comunicación y un orden de reducción de coma flotante distinto. Las actualizaciones escalares atómicas pueden anular las ganancias paralelas. Particionar K puede ayudar con problemas de M/N muy pequeños, pero no es una transformación gratuita.
La distribución estática es adecuada para bloques de tamaño parecido. Los bordes y los tiempos variables de transferencia generan desequilibrio; una cola dinámica mejora el equilibrio a cambio de planificación adicional. Los conflictos en bancos compartidos o una ruta DMA saturada pueden hacer que añadir trabajadores ralentice la ejecución. La eficiencia de escalado debe comparar la misma carga y algoritmo con uno y p trabajadores, en lugar de comparar una referencia escalar con otro algoritmo optimizado.
El clúster de ocho núcleos de GAP8 es una capacidad arquitectónica. Demostrar una implementación en el clúster exige evidencia del lanzamiento de trabajadores, la partición, la sincronización y el escalado medido; no puede deducirse del experimento en el FC.
Modelado y análisis del rendimiento
Métricas y comparaciones justas
El tiempo de ejecución mide un alcance declarado: solo el kernel, empaquetado más kernel o toda la operación de inferencia. La tasa de cómputo divide la aritmética útil entre el tiempo. Utilice FLOP/s para FP32 y operaciones enteras/s para INT8 con convenciones MAC explícitas. La tasa del kernel y la latencia de extremo a extremo responden a preguntas distintas.
Para cargas y requisitos de corrección idénticos:
E_p denota la eficiencia paralela. T1 y Tp necesitan alcances comparables; cambiar la precisión, omitir el empaquetado o usar valores de beta distintos puede invalidar la interpretación. El ancho de banda efectivo es el número de bytes transferidos dividido entre el tiempo para una frontera especificada, no automáticamente el máximo del bus anunciado por el fabricante.
Registre si los operandos ya están empaquetados, si C está inicializada y si las transferencias están encoladas o son síncronas. Una referencia compilada con reglas distintas de coma flotante no es una comparación controlada. Reutilizar un panel empaquetado en muchas invocaciones solo constituye una carga válida si esa reutilización pertenece a la aplicación descrita.
Deducción de la intensidad operacional de un bloque
La intensidad operacional divide las operaciones útiles entre los bytes que cruzan una interfaz elegida. Para coma flotante también se denomina intensidad aritmética:
Considere una frontera hipotética entre L2 y los búferes locales. Un bloque de salida de BM por BN permanece local durante toda la reducción en K. Los tamaños de entrada son sA y sB; los acumuladores locales utilizan sacc, pero C transferida utiliza sC. Los paneles de K tienen longitudes bk_p cuya suma es K. Suponga que cada panel de entrada requerido cruza una vez para este bloque de salida, que beta exige una lectura de C y que hay una única escritura final de C:
Si se ignoran el relleno y los bordes de M/N:
Para un único panel BK que incluya lectura y escritura de C parcial, sustituya K por BK. Si una planificación vuelca C después de cada panel, contabilice ese coste para cada uno; si la conserva, no invente transferencias intermedias. Mantener la salida residente puede importar más que una pequeña mejora aritmética.
Un cálculo ilustrativo FP32, con BM=BN=BK=32 y sA=sB=sC=4, da 65536 operaciones convencionales y 16384 bytes, o 4 FLOP/byte. Mantener ese bloque de salida residente durante K=256 da aproximadamente 7.11 FLOP/byte en este modelo. Son ejemplos deducidos, no mediciones de GAP8.
Para entradas INT8 con valores parciales o de salida transferidos en INT32, sustituya sA=sB=1 y sC=4 y utilice operaciones enteras. Un acumulador local puede ocupar cuatro bytes aunque la salida cuantizada final utilice uno; emplee el tamaño correcto en cada frontera. Omitir esa anchura exagera la capacidad disponible para bloques.
Beta igual a cero puede eliminar una transferencia inicial explícita, mientras que una caché con asignación por escritura aún puede cargar una línea ante un fallo de escritura. El relleno, los paneles repetidos, el empaquetado y las recargas cambian Q. Distinga una estimación de huella del tráfico medido e indique si los bytes proceden de descriptores DMA, contadores de hardware o un modelo. Identifique los eventos de los contadores en lugar de presentar una cifra de ancho de banda sin explicar.
Roofline: techos y punto de cruce
Roofline relaciona la capacidad aritmética con el suministro de datos R9. Sea Ppeak un techo de cómputo en operaciones útiles/s, Bmemory el ancho de banda sostenible en bytes/s e I la intensidad en operaciones/byte:
Bmemory*I tiene unidades de operaciones/s. En ejes logarítmicos forma un techo inclinado de ancho de banda; el techo de cómputo es horizontal. Su intersección es el punto de cruce:
Por debajo de esa intensidad, ni siquiera un kernel ideal puede alimentar el cómputo máximo a través de la interfaz modelada. Por encima, aumentar únicamente la reutilización no puede elevar ese techo. La distinción identifica un recurso limitante del modelo; no demuestra que un punto medido lento haya alcanzado alguno de los techos.
Roofline normalizado e ilustrativo
El diagrama es normalizado e ilustrativo, sin ancho de banda ni tasa de cómputo medidos en GAP8. Un kernel puede quedar por debajo de ambos techos debido a dependencias entre instrucciones, generación de direcciones, mala utilización de vías, sincronización, conflictos entre bancos o sobrecarga en problemas cortos. Desplazarse a la derecha mediante empaquetado no es automáticamente beneficioso si se han excluido del punto representado el tiempo o el tráfico de ese empaquetado.
Un pico teórico procede de un modelo de tasa de instrucciones y frecuencia de reloj. Un techo de cómputo medido procede de un kernel de calibración documentado. El ancho de banda sostenible debe corresponder al patrón y la dirección de acceso: una copia secuencial larga puede no predecir transferencias DMA bidimensionales cortas. Combinar el máximo teórico del bus con tasas medidas del kernel genera una cota optimista, no un techo alcanzable medido.
El análisis Roofline jerárquico asigna a cada interfaz su propio recuento de tráfico y ancho de banda: registros/memoria local, local/L2 y memoria externa cuando exista. Un kernel puede tener alta intensidad en una frontera y seguir limitado en otra:
Cada par debe utilizar la misma frontera y convención de operaciones. Techos adicionales pueden describir la mezcla de instrucciones, el ancho de emisión y la ocupación imperfecta de vías. Trátelos como hipótesis hasta fundamentarlos en comportamiento arquitectónico verificado o mediciones.
Adaptación de Roofline a GAP8
Seleccione primero FC o clúster. Especifique el kernel entero, el SDK y las instrucciones generadas. Si una función auxiliar de producto escalar se expande en software, la tasa de emisión del producto escalar empaquetado nativo no es el techo de cómputo del kernel ejecutado. Calibre lo que realmente se ejecuta.
Para una propuesta con DMA, mida transferencias entre memoria local y L2 con las mismas formas, alineación, cantidad de descriptores y actividad concurrente. Cuente los descriptores completados y el resto del tráfico en esa frontera. Compare transferencias aisladas y solapadas para revelar contención. Este paquete educativo no aporta calibración verificada del dispositivo, por lo que quedan pendientes nuevos techos numéricos y gráficos de aceleración de GAP8.
Costes de comunicación y umbral de amortización
Un modelo serial sencillo es:
Con recursos independientes de transferencia y cómputo, una ejecución segmentada sustituye las sumas repetidas por su máximo, más arranque, vaciado y sincronización. Esa sustitución falla cuando un único núcleo ejecuta ambas fases o cuando recursos compartidos las serializan. Incluya explícitamente el empaquetado salvo que se demuestre su solapamiento.
Suponga que un empaquetado inicial cuesta Tp y ahorra deltaT por reutilización del panel. Con R usos, la condición elemental de amortización es:
DeltaT debe incluir los cambios de cómputo y movimiento. Un panel más ancho puede reducir transferencias repetidas a la vez que aumenta el empaquetado y la presión de capacidad. Las transformaciones que evitan comunicación conservan o fusionan resultados intermedios útiles; también pueden aumentar el almacenamiento vivo y la complejidad de planificación. Optimice el coste medido de la operación completa requerida, no un recuento aislado que omita el nuevo trabajo.
La energía y la potencia requieren mediciones
La potencia es energía por unidad de tiempo. Durante un intervalo medido:
Con idéntico intervalo y alcance de recuento, la tasa de cómputo dividida entre la potencia media equivale a operaciones por julio. Una ejecución más corta puede reducir la energía y aumentar la potencia instantánea; una frecuencia menor puede reducir la potencia y prolongar la ejecución. Ninguna tendencia por sí sola demuestra eficiencia.
La energía de la aplicación debe incluir el movimiento de datos requerido y las esperas inactivas. Indique si la instrumentación cubre una línea de alimentación del chip, la placa o el sistema y si se resta la energía en reposo. Aquí no se aportan cifras de ahorro energético, trazas de potencia ni mediciones de energía por operación.
Metodología reproducible de pruebas de rendimiento
El paquete descargable incluye un ejemplo de prueba de rendimiento en el anfitrión con temporizador monotónico POSIX, calentamiento, mediciones repetidas, comprobaciones de corrección y resúmenes estadísticos. No es una implementación del temporizador de GAP8. Todos los kernels comparados utilizan M/N/K idénticos, almacenamiento FP32 por filas y alpha=1, beta=0. La reserva y la inicialización de entradas quedan fuera de la región medida; todo el trabajo del kernel, incluida la inicialización o el escalado de C, queda dentro.
/* POSIX host harness excerpt: setup/reference/checks occur outside timing. */
static double measure_kernel(int algorithm, size_t m, size_t n, size_t k,
                              const float *a, const float *b, float *c) {
    double start = seconds();
    int status = invoke(algorithm, m, n, k, a, b, c);
    double elapsed = seconds() - start;
    if (status != GEMM_OK) exit(EXIT_FAILURE);
    return elapsed;
}
Este fragmento compilado es compartido por ambas traducciones. El programa completo aporta inicialización, validación de argumentos, comparaciones con la referencia e informes. Ejecute bash run_checks.sh antes de medir. Su salida de Linux/WSL describe únicamente el anfitrión y nunca debe presentarse como resultados de GAP8.
| Elemento | Registro requerido |
|---|---|
| Hardware | Placa/procesador, memoria, FC o clúster, núcleos activos, frecuencia y política de potencia |
| Cadena de herramientas | Versiones del compilador/SDK, opciones exactas, revisión del código, evidencia de instrucciones |
| Carga de trabajo | M/N/K, alfa/beta, precisión, rangos de entrada, disposición, pasos y tamaños de bloque |
| Alcance | Reserva, empaquetado, transferencias, sincronización y conversión incluidos/excluidos |
| Medición temporal | Resolución y sobrecarga del temporizador, calentamiento, repeticiones y sincronización de finalización |
| Resultados | Muestras sin procesar, mediana/mínimo/dispersión, tolerancia de corrección y referencia |
El calentamiento debe corresponder a la pregunta. Una prueba de microkernel con caché caliente estudia reutilización; una prueba de inferencia con arranque en frío incluye el trabajo del primer uso. Registre la gestión del estado en lugar de presentar cualquiera de los regímenes como universalmente representativo. Alterne o aleatorice el orden de los algoritmos cuando efectos térmicos o de fondo puedan sesgar una secuencia fija. El escalado de frecuencia y la limitación térmica pueden cambiar las tasas basadas en tiempo transcurrido pese a usar código idéntico.
Mida trabajo completado: encerrar únicamente el lanzamiento del DMA mide el envío, no la transferencia. Un reloj monotónico evita ajustes del reloj civil, pero los kernels cortos pueden seguir acercándose a la sobrecarga o resolución del temporizador. Agrupe suficiente trabajo equivalente para superar ese coste e indique si las llamadas repetidas reutilizan operandos empaquetados o datos en caché. Conserve las muestras sin procesar en lugar de restar a cada medición una estimación ruidosa de la sobrecarga.
Las llamadas repetidas con beta=1 hacen crecer C y pueden terminar en desbordamiento. Restablézcala fuera de la medición declarando ese alcance, o incluya el coste de restablecimiento de forma coherente. Conserve una validación observable de la salida para evitar la eliminación de código muerto; convertir todos los arreglos en volatile cambia el comportamiento de memoria estudiado. Compruebe el código generado cuando la optimización de todo el programa o una propagación agresiva de constantes puedan invalidar una microprueba de rendimiento.
La cobertura de corrección debe incluir matrices pequeñas y no cuadradas, bloques de borde, pasos con relleno, ceros, variantes alfa/beta y entradas aleatorias deterministas. Compare FP32 con una referencia independiente de acumulador más ancho, usando tolerancias apropiadas para K y el rango de entrada. La tolerancia incluida corresponde a casos didácticos acotados, no es una garantía numérica universal. Compruebe resultados enteros exactos cuando sean representables y pruebe los límites de desbordamiento antes de convertir.
Publique la configuración y las muestras sin procesar junto a cualquier tasa declarada. Un mínimo puede aproximar condiciones favorables de la máquina, mientras que la mediana y la dispersión caracterizan el comportamiento típico de esa ejecución. Ninguno es universalmente el resumen correcto. Separe las mejoras del kernel de las ganancias de la aplicación completa. La ejecución nueva en GAP8, la validación de ciclos e instrucciones y los experimentos de energía quedan pendientes de acceso a la plataforma correspondiente.
Referencias y material original conservado
- Cristian Ramírez et al. A BLIS-like matrix multiplication for machine learning in the RISC-V ISA-based GAP8 processor. The Journal of Supercomputing, 2022. DOI:
10.1007/s11227-022-04581-6. Alcance de implementación/FC: §§3–4; trabajo futuro: §5. - crissmath/qblis_gpduino, revisión examinada
53f8bc6187470a435c501fbfb6ef58267c431b75. README relaciona el código con R1; su disponibilidad no demuestra la identidad del artefacto histórico. - Field G. Van Zee y Robert A. van de Geijn. BLIS: A Framework for Rapidly Instantiating BLAS Functionality. ACM Transactions on Mathematical Software, 2015.
- Mantenedores de BLIS. Documentación de kernels y documentación de ejecución multihilo.
- BLAS de referencia. Especificación y código de DGEMM.
- GreenWaves Technologies. GAP8 Hardware Reference Manual, v1.5.5. Documentación de FC/clúster, memoria, DMA y conjunto de instrucciones.
- Google. Especificación de cuantización de 8 bits de LiteRT. Un ejemplo de un entorno de ejecución, no una afirmación sobre toda la cadena de procesamiento de la investigación.
- Proyecto LLVM. Clang Compiler User’s Manual: comportamiento de coma flotante.
- Samuel Williams, Andrew Waterman y David Patterson. Roofline: An Insightful Visual Performance Model for Floating-Point Programs and Multicore Architectures. Informe técnico UCB/EECS-2008-134, 2008.
- GreenWaves Technologies. GAP SDK
Gap8.h, rutas con funciones intrínsecas del objetivo y emulación en el anfitrión. Esta revisión no identifica la versión del SDK de 2022.
Se conservan el póster de investigación (PDF) y la atribución original. La referencia del artículo anterior a Alman y Williams (2020) permanece como contexto asintótico más allá de la multiplicación clásica, no como un algoritmo implementado aquí. Todos los diagramas nuevos son originales explicativos. Consulte el proyecto de investigación para las publicaciones y la evidencia de ingeniería.