Resumen
Cristian Ramírez · Literatura contrastada: 22 de noviembre de 2026.
La multiplicación de matrices tiene dos fronteras de optimización diferentes. La complejidad algebraica estudia cómo crece con la dimensión el número de operaciones aritméticas exactas. La ingeniería de rendimiento estudia cómo una implementación concreta utiliza registros, memoria, unidades aritméticas y energía, todos ellos recursos finitos. Su interacción resulta productiva precisamente porque las respuestas son distintas. Siete productos de bloques pueden sustituir a ocho y, aun así, un kernel cúbico con un empaquetado cuidadoso puede superar a una construcción más sofisticada en los tamaños que caben en una máquina.
Este artículo desarrolla el vínculo entre ambas fronteras. Deduce la identidad y la recurrencia de Strassen, introduce tensores, restricciones, rango frontera y la desigualdad asintótica de la suma, y recorre quince hitos históricos desde 1969 hasta el método láser asimétrico de 2024/2025. A continuación examina trabajos de investigación difundidos en 2026, distinguiendo un certificado de optimización, los artefactos disponibles de una demostración formal, manuscritos posteriores independientes y revisión por pares. Por último, relaciona la reducción de operaciones aritméticas con la estabilidad, la comunicación, la organización de tipo BLIS y mi trabajo sobre GEMM entero para el procesador RISC-V GAP8.
Los valores numéricos son cotas superiores de un exponente matemático, no aceleraciones medidas. Los resultados procedentes de otros trabajos se citan; los ejemplos breves y los modelos de coste se deducen aquí. No he vuelto a ejecutar los optimizadores históricos, el certificado numérico reciente ni la comprobación completa de la demostración y sus dependencias en Lean. Algunas demostraciones originales tempranas no fueron accesibles; sus apartados precisan qué establecen los registros primarios disponibles. Se trata de una síntesis crítica de la literatura y una exposición de ingeniería, sin afirmar que haya verificado de forma independiente todas las demostraciones o descubierto un exponente nuevo.
Por qué el problema sigue abierto
Para dos matrices cuadradas densas, la fórmula habitual contiene n³ multiplicaciones escalares. Ese recuento corresponde a un algoritmo concreto. No es una cota inferior para cualquier procedimiento que calcule la misma aplicación bilineal. Reutilizar combinaciones algebraicas entre distintas salidas permite reducir las multiplicaciones, a cambio de introducir sumas adicionales y dependencias de datos más complejas.
La distancia entre una salida de tamaño cuadrático y un algoritmo cúbico de manual es, por tanto, una cuestión de representación. ¿Con qué economía se pueden expresar simultáneamente todos los coeficientes de salida? Una vez encontrada una expresión económica, ¿pueden organizarse sus productos en multiplicaciones de matrices grandes e independientes? ¿Puede amplificarse una construcción finita sin perder su ahorro debido a interferencias, al coste de la aproximación o a la comunicación? Cada etapa histórica que se presenta a continuación modifica una de esas preguntas.
El problema también muestra los límites de una sola métrica. Reducir una potencia de n resulta decisivo asintóticamente, pero no determina el crecimiento de los coeficientes, la memoria de trabajo, la precisión, el paralelismo ni el rendimiento aritmético alcanzable. El ingeniero debe examinar conjuntamente el grafo del algoritmo y la máquina. Un artículo que mejora ω y un kernel que reduce la latencia de inferencia pueden ser importantes sin resolver el mismo problema de optimización.
La cronología de mi tesis
Las siguientes imágenes reproducen la Tabla C.1 y la Figura C.1 originales de mi tesis doctoral. Conservan la cronología histórica tal como aparecía allí. Los bytes de las imágenes no se han modificado. La cronología verificada que aparece más adelante añade distinciones entre publicaciones y versiones, así como investigación posterior al último punto de las figuras; no corrige los originales de forma silenciosa. La atribución de la tesis se recoge en la referencia 33.
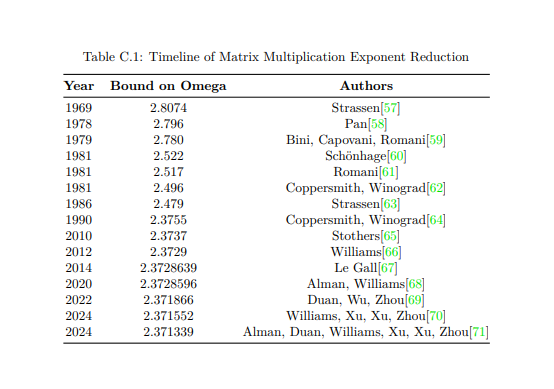
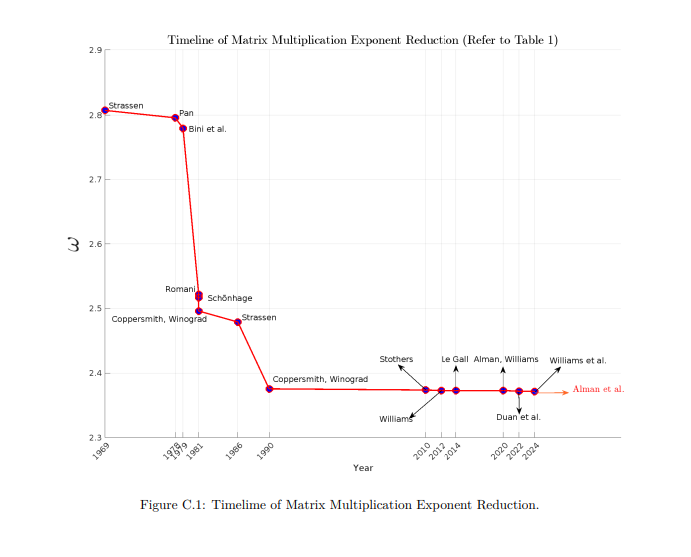
Transcripción accesible de la Tabla C.1 original
| Año | Cota de omega | Autores tal como aparecen |
|---|---|---|
| 1969 | 2.8074 | Strassen |
| 1978 | 2.796 | Pan |
| 1979 | 2.780 | Bini, Capovani, Romani |
| 1981 | 2.522 | Schönhage |
| 1981 | 2.517 | Romani |
| 1981 | 2.496 | Coppersmith, Winograd |
| 1986 | 2.479 | Strassen |
| 1990 | 2.3755 | Coppersmith, Winograd |
| 2010 | 2.3737 | Stothers |
| 2012 | 2.3729 | Williams |
| 2014 | 2.3728639 | Le Gall |
| 2020 | 2.3728596 | Alman, Williams |
| 2022 | 2.371866 | Duan, Wu, Zhou |
| 2024 | 2.371552 | Williams, Xu, Xu, Zhou |
| 2024 | 2.371339 | Alman, Duan, Williams, Xu, Xu, Zhou |
Varias entradas necesitan contexto. El artículo de 1979 también incluye a Grazia Lotti. Algunos años identifican un anuncio en lugar de la publicación en revista. Algunos valores son redondeos conservadores; otro combina el año del envío inicial con una versión posterior mejorada. Un punto de la gráfica tampoco indica si la desigualdad es estricta, qué cuerpo se admite o si un manuscrito corregido sustituye un resultado anunciado anteriormente. Estas distinciones corresponden al análisis textual, no a una figura de sustitución inventada.
Multiplicación clásica y modelo aritmético
Sea F un cuerpo, A una matriz m×k con entradas en F y B una matriz k×n con entradas en F. El producto exacto se define mediante
Para matrices cuadradas de orden n, los productos escalares independientes requieren n³ multiplicaciones y n²(n−1) sumas cuando una suma de longitud n comienza con su primer término. El total es 2n³−n². Una implementación que, en cambio, acumula sobre una C existente puede ejecutar n³ sumas. El recuento principal habitual de 2n³ considera una multiplicación-suma como dos operaciones de coma flotante, incluso cuando la ejecuta una sola instrucción FMA. Las operaciones aritméticas, las instrucciones y los ciclos son recuentos distintos.
El intercambio de bucles, el empaquetado y el bloqueo para caché pueden modificar radicalmente el tiempo de ejecución sin alterar estos recuentos clásicos de operaciones. A la inversa, un algoritmo algebraico puede reducir las multiplicaciones e introducir más movimiento de datos. La distinción evita una inferencia errónea habitual: observar una implementación bloqueada más rápida no demuestra que tenga un exponente menor.
Definimos el exponente aritmético de multiplicación de matrices cuadradas sobre F mediante
Aquí MM cuenta sumas, restas y multiplicaciones exactas del cuerpo en el modelo aritmético especificado. Las constantes pueden depender del cuerpo y del algoritmo fijados; la dimensión es la variable asintótica. En este artículo, el modelo principal son las identidades bilineales finitas y su evaluación recursiva sin divisiones. Leer las entradas, escribir las salidas, realizar aritmética de palabras finitas y transferir datos entre memorias requiere contabilización adicional en una máquina. El intervalo convencional es 2 ≤ ω ≤ 3; el extremo inferior es una obstrucción dimensional elemental, no una prueba de que se haya construido una multiplicación cuadrática.
El ínfimo y el margen positivo del exponente son importantes. Un teorema ω ≤ τ proporciona, en general, para cada ε > 0, una familia O(n elevado a τ+ε). No tiene por qué ofrecer una única rutina uniforme O(n elevado a τ) con una constante moderada. El algoritmo base puede depender de ε y crecer enormemente cuando ε disminuye. Sustituir esa estructura de cuantificadores por un kernel ejecutable breve cambiaría sustancialmente la afirmación.
Cuerpos, bits y formas rectangulares
Una suma exacta en Q no equivale a una instrucción de máquina de coste constante. Los numeradores y denominadores racionales crecen; la multiplicación de enteros depende de la longitud en bits. Las operaciones de coma flotante siguen una semántica distinta, con redondeo. Un exponente aritmético puede orientar el análisis de complejidad en bits, pero no lo proporciona sin cotas para el tamaño de los coeficientes y la precisión.
Las extensiones de cuerpos también deben contabilizarse. Una extensión fija de grado d puede representarse en una base fija y simularse con un número acotado de operaciones del cuerpo base que depende de d. Así, una operación compleja fija puede simularse mediante un número constante de operaciones reales sobre dos coordenadas, y las identidades reales se extienden a entradas complejas. Esto establece la igualdad de los exponentes aritméticos real y complejo correspondientes en este modelo. No iguala su coste en hardware ni su estabilidad.
Una constante compleja no tiene por qué ser racional, por lo que el mismo argumento de las dos coordenadas no permite descender a Q. La algebraización o el descenso a un cuerpo de números necesitan una demostración propia. Las extensiones cuyos grados crecen con n constituyen otro caso: un crecimiento polinómico puede alterar el exponente, mientras que un grado polilogarítmico con coste de simulación polinómico solo introduce un sobrecoste subpolinómico. Fijar ε, después fijar una construcción finita y su cuerpo de coeficientes, y finalmente hacer crecer n es distinto de ampliar el cuerpo con cada dimensión de entrada.
Por último, escribimos ω(a,b,c) para el exponente de multiplicar una matriz nᵃ×nᵇ por otra nᵇ×nᶜ. El caso cuadrado es ω(1,1,1). El exponente dual α es, por convención, el supremo de los k para los que ω(1,k,1)=2. Una nueva cota rectangular o dual puede ser importante sin representar el mismo número que una cota para el caso cuadrado. La forma también es una variable práctica central: una dimensión de reducción larga y dos dimensiones exteriores pequeñas exponen una reutilización y un paralelismo distintos de los de un producto cuadrado.
Aplicaciones bilineales, tensores y extracción asintótica
Un algoritmo bilineal exacto calcula productos de formas lineales de las dos entradas y los recombina linealmente. Si las entradas de A y B se indexan mediante coordenadas individuales a y b, un algoritmo de r productos tiene la forma
Los coeficientes son elementos fijos de F, independientes de las entradas. Expresan una identidad reutilizable, no productos elegidos tras observar ceros concretos. Codificar la salida con variables duales da lugar a la forma trilineal
Los índices de z cierran el ciclo. Las variables z registran las salidas; evaluar esta forma permite codificar simultáneamente todas las identidades entre coeficientes. Permutar los tres modos del tensor relaciona distintos productos rectangulares, pero no autoriza a intercambiar el orden de factores matriciales no conmutativos dentro de una implementación.
El rango tensorial R(T) es el número mínimo de tensores simples cuya suma es T. Una descomposición de rango r proporciona r productos bilineales. Las sumas y las aplicaciones lineales escalares siguen requiriendo trabajo. Para una construcción base fija utilizada recursivamente, su trabajo cuadrático por nodo puede absorberse en la recurrencia aritmética subcúbica resultante. Si la propia construcción base crece con la entrada, ese argumento debe revisarse.
Los productos tensoriales codifican elecciones independientes simultáneas en cada nivel recursivo:
Una restricción aplica transformaciones lineales por separado a los tres modos. Anular variables seleccionadas es una restricción especialmente transparente. Una degeneración permite transformaciones dependientes de un parámetro cuyo coeficiente principal o forma límite es el objetivo. Escribimos S ⊑ T para una degeneración de T a S. La dirección importa: una fuente económica puede producir un objetivo, no a la inversa.
Rango frontera: un límite de expresiones exactas
El rango frontera, que a continuación se escribe con subrayado, es el menor r para el que T es una degeneración de r productos simples. Puede ser inferior al rango exacto. La aproximación es aquí algebraica: un parámetro tiende a cero y el tensor deseado aparece como un coeficiente especificado. No garantiza que sustituir el parámetro por un número de coma flotante diminuto produzca un cálculo preciso.
Un ejemplo deducido de forma independiente concreta la distinción. En espacios bidimensionales con base e₀,e₁, definimos
Al desarrollar la expresión siguiente se obtiene W más términos divisibles por t:
Para t no nulo, el miembro izquierdo es una suma de dos tensores simples, cuyos factores escalares se absorben en uno de los modos. Por tanto, su rango frontera es como máximo dos. Una matricización respecto de uno de los modos tiene rango dos, de modo que el rango frontera es exactamente dos. El desarrollo mostrado, por sí solo, no demuestra una descomposición de rango exacto dos de W; únicamente demuestra una degeneración. Este ejemplo no se presenta como una construcción histórica para multiplicar matrices.
Para convertir una degeneración en aritmética asintótica exacta, pueden extraerse coeficientes mediante interpolación después de tomar potencias tensoriales. Si una degeneración fija tiene grado d, su potencia de orden N tiene grado como máximo dN. Sobre un cuerpo suficientemente grande, recuperar un coeficiente solo cuesta O(dN) evaluaciones, un factor cuya raíz de orden N tiende a uno. Los cuerpos finitos pequeños requieren contabilizar la extensión y el descenso. Este es el mecanismo por el que el rango frontera puede controlar un exponente aritmético exacto; no es una instrucción para dividir por un infinitesimal en un procesador. La conversión posterior de Bini entre cálculo exacto y aproximado proporciona el vínculo histórico 5.
La desigualdad asintótica de la suma
Supongamos que un tensor de rango frontera como máximo r degenera en una suma directa de productos matriciales con espacios de variables disjuntos en los tres modos. La desigualdad asintótica de la suma establece
Las hipótesis sobre el cuerpo y la extracción de coeficientes acompañan a esta afirmación asintótica; no se trata de una igualdad de rangos finitos. Una variable compartida puede romper la independencia de la suma directa aunque dos productos escritos parezcan separados. Gran parte del método láser se dedica a extraer suficientes productos y a eliminar precisamente esas interacciones no deseadas 6, 10.
Como comprobación ilustrativa, dos productos independientes de matrices 2×2 pueden utilizar los siete productos de Strassen cada uno, por lo que su suma directa tiene rango como máximo catorce. La desigualdad queda
El ejemplo recupera deliberadamente la cota existente. Escribir una suma directa no crea por sí solo una mejora. Para mejorar se necesita una fuente que agrupe los productos independientes con menor coste que el de pagarlos por separado. Ese es el paso conceptual que supera una única recurrencia de bloques.
1969 — Strassen: siete productos sustituyen a ocho
Gaussian Elimination is not Optimal, de Volker Strassen, establece una identidad exacta finita, el cuestionamiento más directo posible de la intuición cúbica 1. Dividimos A y B en cuatro bloques cuadrados del mismo tamaño. Los siete productos son
Se recombinan mediante
Por ejemplo, al desarrollar la primera salida se obtiene
Todos los términos cruzados no deseados se cancelan. Se conserva el orden de los operandos, por lo que la identidad funciona para bloques matriciales y, de forma más general, sobre un anillo con resta; no depende de que los bloques de A y B conmuten. Las otras tres salidas se desarrollan de la misma manera explícita. La multiplicación no utiliza divisiones, a diferencia de un procedimiento de inversión cuyos pivotes pueden imponer hipótesis adicionales.
Hay diez sumas/restas de bloques para preparar los operandos y ocho para recombinar los resultados. Si el orden cuadrado es una potencia de dos y el umbral del caso base está fijado,
La recurrencia cuenta aritmética con entradas de coste unitario. Su exponente procede de las siete llamadas hijas, mientras que las sumas cuadráticas aportan un término de orden inferior. Una identidad de rango finito se ha convertido en un algoritmo asintótico. Es una cota superior constructiva, no una cota inferior coincidente para todos los métodos de multiplicación.
Para un n positivo arbitrario, puede rellenarse hasta la siguiente potencia de dos p. Como n ≤ p < 2n, el exponente asintótico no cambia, pero la constante y el trabajo desperdiciado pueden ser considerables. Una biblioteca real puede, en cambio, tratar por separado los bordes irregulares o elegir una recursión adaptada a la forma. El relleno matemático es un argumento de corrección; no tiene por qué ser una recomendación de implementación.
Una identidad ejecutable y probada
La siguiente fuente Python, que solo utiliza la biblioteca estándar, se comparte entre ambas versiones lingüísticas. Acepta matrices cuadradas del mismo tamaño, aplica relleno y recorte en el cálculo recursivo y utiliza un caso base clásico configurable. Los enteros y Fraction permiten aritmética exacta; utilizar números de coma flotante cambia la semántica numérica. Esta implementación con asignación de memoria tiene una finalidad pedagógica, sin atribuirle rendimiento comparable al de BLAS ni un umbral ajustado experimentalmente.
"""Educational square-matrix multiplication over an exact ring.

Use immutable entries supporting +, -, *, and integer zero, such as int or
fractions.Fraction. No floating-point conversion or input mutation is performed.
These allocating Python routines demonstrate identities, not optimized BLAS.
"""


def _validate(a, b):
    for matrix in (a, b):
        if not isinstance(matrix, (list, tuple)):
            raise TypeError("matrices must be lists or tuples of rows")
        if any(not isinstance(row, (list, tuple)) for row in matrix):
            raise TypeError("matrix rows must be lists or tuples")
        if any(len(row) != len(matrix) for row in matrix):
            raise ValueError("each matrix must be square")
    if len(a) != len(b):
        raise ValueError("matrices must have the same order")
    return len(a)


def _classical(a, b):
    n = len(a)
    c = [[0] * n for _ in range(n)]
    for i in range(n):
        for k in range(n):
            for j in range(n):
                c[i][j] += a[i][k] * b[k][j]
    return c


def classical(a, b):
    """Return a*b for equally sized square matrices; [] represents order zero."""
    _validate(a, b)
    return _classical(a, b)


def _combine(a, b, subtract=False):
    return [[x - y if subtract else x + y for x, y in zip(ar, br)]
            for ar, br in zip(a, b)]


def _split(a):
    h = len(a) // 2
    return ([row[:h] for row in a[:h]], [row[h:] for row in a[:h]],
            [row[:h] for row in a[h:]], [row[h:] for row in a[h:]])


def strassen(a, b, leaf_size=32):
    """Return a*b with seven-product recursion and classical leaf products.

    Pad to p, the next power of two, and crop the returned matrix to order n.
    leaf_size must be a positive int (bool is rejected); it is a teaching
    parameter, not a measured crossover. Entries are not type-restricted:
    exactness requires exact ring operations; floats do not gain that property.
    """
    if type(leaf_size) is not int:
        raise TypeError("leaf_size must be an integer")
    if leaf_size < 1:
        raise ValueError("leaf_size must be positive")
    n = _validate(a, b)
    if n == 0:
        return []
    p = 1 << (n - 1).bit_length()

    def pad(matrix):
        return ([list(row) + [0] * (p - n) for row in matrix]
                + [[0] * p for _ in range(p - n)])

    def multiply(x, y):
        if len(x) <= leaf_size:
            return _classical(x, y)
        a11, a12, a21, a22 = _split(x)
        b11, b12, b21, b22 = _split(y)
        add = _combine

        def sub(u, v):
            return _combine(u, v, subtract=True)

        m1 = multiply(add(a11, a22), add(b11, b22))
        m2 = multiply(add(a21, a22), b11)
        m3 = multiply(a11, sub(b12, b22))
        m4 = multiply(a22, sub(b21, b11))
        m5 = multiply(add(a11, a12), b22)
        m6 = multiply(sub(a21, a11), add(b11, b12))
        m7 = multiply(sub(a12, a22), add(b21, b22))
        c11 = add(sub(add(m1, m4), m5), m7)
        c12 = add(m3, m5)
        c21 = add(m2, m4)
        c22 = add(add(sub(m1, m2), m3), m6)
        return ([u + v for u, v in zip(c11, c12)]
                + [u + v for u, v in zip(c21, c22)])

    product = multiply(pad(a), pad(b))
    return [row[:n] for row in product[:n]]
Desde la raíz del repositorio, ejecute python -B examples/matrix-history/test_strassen.py. Las trece pruebas comprueban la identidad con polinomios formales no conmutativos, los recuentos de multiplicaciones, enteros y fracciones aleatorios con aritmética exacta, dimensiones impares, relleno, entradas no válidas y conservación de las entradas. Las pruebas exactas validan estas identidades algebraicas y estos casos; no establecen una cota de error en coma flotante.
Con evaluación en profundidad, el almacenamiento auxiliar máximo es de O(p²) posiciones de entradas de matriz y la profundidad de la recursión es O(log p). Esto cuenta posiciones simultáneamente activas, no la asignación acumulada ni los bits que ocupan números exactos crecientes. Los siete resultados intermedios siguen ocupando memoria, y el sobrecoste de los objetos de Python queda fuera del modelo aritmético. Tanto el algoritmo como sus limitaciones declaradas forman parte del ejemplo.
1978 — Pan: la agregación cambia la unidad de optimización
La agregación trilineal de Victor Pan fue más allá de repetir recursivamente una pequeña identidad cuadrada. El objetivo pasa a ser un conjunto de productos representados de forma conjunta, de manera que los términos útiles puedan compartir una expresión agregada y los términos no deseados se cancelen explícitamente. El trabajo de FOCS de 1978 es el hito histórico; el artículo original posterior de Pan en revista documenta el enfoque de agregación, unión y cancelación 2, 3.
Un pequeño desarrollo esquemático explica tanto el atractivo como la dificultad. Para símbolos independientes, una agregación produce
Dos términos trilineales deseados aparecen en una sola agregación, pero también aparecen seis términos de interferencia. Esto no es el algoritmo de Pan ni una mejora de rango: pagar por cada corrección por separado podría anular todo el ahorro. Una construcción satisfactoria organiza muchas expresiones de este tipo para que las propias correcciones tengan una estructura económica. Contar únicamente los términos diagonales deseados daría un análisis de complejidad no válido.
El artículo de Bini de 1979 sitúa la cota de Pan aproximadamente en 2.7951, lo que respalda la entrada conservadora de 2.796 en la cronología. No obtuve una demostración original legible de 1978 y, por tanto, no afirmo reproducir sus parámetros exactos de agregación ni sus restricciones sobre el cuerpo. En particular, una descomposición base de gran tamaño citada habitualmente no se convierte aquí en un teorema contrastado solo porque su logaritmo coincida numéricamente con la cota.
La importancia conceptual queda, sin embargo, clara: el espacio de optimización incorpora ahora combinaciones de productos en lugar de una sola recurrencia local. La consecuencia para la ingeniería es una pregunta, no una aceleración automática. ¿Cuántas combinaciones lineales temporales y pasadas de corrección necesita la construcción, y pueden compartir el empaquetado o permanecer en memoria rápida? Sin esa correspondencia, un ahorro aritmético puede aumentar el tráfico. La agregación introduce una reutilización algebraica que después debe convertirse en reutilización física.
1979 — Bini, Capovani, Romani y Lotti: aproximarse a un tensor
El original de dos páginas de Dario Bini, Milvio Capovani, Francesco Romani y Grazia Lotti estudia construcciones bilineales aproximadas con un parámetro que tiende a cero 4. La cuarta autora, ausente de la imagen de la tesis, debe restituirse en la exposición académica. La construcción cuadrada resultante tiene el recuento aritmético resumido por
El artículo combina productos rectangulares aproximados y variantes cíclicas para obtener esta relación entre dimensión y número de productos. El parámetro de aproximación pertenece a un argumento de límite algebraico. El artículo independiente de Bini de 1980 proporciona la relación de interpolación entre cálculo exacto y aproximado 5. Sería histórica y matemáticamente incorrecto tratar una sustitución con precisión fija en la fórmula de 1979 como si fuera ese teorema de conversión exacta.
¿Por qué puede una construcción límite mejorar un exponente exacto? Fijemos una degeneración de grado d antes de amplificarla. Una potencia tensorial de orden N tiene un grado que crece como máximo linealmente, dN, mientras que el número de productos útiles crece exponencialmente con N. La extracción de coeficientes introduce un factor polinómico en N; tomar raíces de orden N lo elimina de la comparación asintótica. La ganancia procede del orden en que se toman esos límites, no de ignorar el error de aproximación.
En cálculo numérico la situación se invierte: las expresiones divididas por un parámetro pequeño pueden amplificar el redondeo y la cancelación. Elegir un parámetro menor reduce el error de truncamiento, pero puede aumentar el error de redondeo o el rango de los coeficientes. El argumento de interpolación en aritmética exacta evita ese procedimiento numérico; no demuestra que la evaluación directa del límite sea estable. La propia carta original deja sin resolver el coste práctico en bits y la estabilidad.
Este hito amplía la búsqueda: de descomposiciones que coinciden con el tensor para todo valor del parámetro a familias que se aproximan a él. El rango frontera se convierte en un recurso algebraico. La disciplina esencial consiste en distinguir tres afirmaciones: una identidad aproximada, una conversión asintótica exacta y una implementación estable con precisión finita. Ninguna se deduce de escribir las otras dos junto a un exponente decimal.
1981 — Schönhage: los productos independientes tienen valor colectivo
Partial and Total Matrix Multiplication, de Arnold Schönhage, relaciona el rango aproximado y los productos simultáneos 6. El registro del editor establece una cota sobre un cuerpo arbitrario ligeramente inferior a
La desigualdad asintótica de la suma es el avance estructural que perdura más allá de ese decimal concreto. Su formulación se reconstruye en el artículo original CW1990, que sí fue legible aunque la demostración completa de Schönhage no estuviera disponible en esta auditoría 10. Si una fuente de rango aproximado L proporciona productos disjuntos, se resuelve la ecuación monótona
El exponente aritmético resultante es como máximo 3τ, con un margen positivo en el exponente al enunciar un tiempo de ejecución concreto. El factor tres convierte el volumen de un tensor de multiplicación en dimensión cuadrada. Omitirlo confundiría el volumen del tensor con el orden de la matriz.
Por ejemplo, supongamos que una fuente hipotética proporciona dos productos independientes de volúmenes v₁ y v₂. Su desigualdad de viabilidad compararía L con v₁ elevado a τ más v₂ elevado a τ, no solo con el volumen mayor. Ambas salidas contribuyen. A la inversa, colocarlas en una expresión algebraica compartida no demuestra su independencia: cada espacio de entrada y de salida debe descomponerse de la forma adecuada. Un producto parcial puede ser valioso porque la amplificación y la extracción posteriores aprovechen su estructura, no porque ya sea una multiplicación cuadrada completa.
Esto reformula el objetivo de diseño en términos del contenido productivo de un tensor fuente. Ayuda a explicar por qué las construcciones posteriores suelen parecer alejadas de un GEMM ejecutable. Primero crean muchos productos potenciales, después aíslan una suma directa útil y, por último, invocan un teorema asintótico. La secuencia demuestra la existencia de un algoritmo aritmético; todavía deja un problema de implementación que comprende tamaños, coeficientes, extracción y organización de memoria.
1981/1982 — Romani: el análisis de sumas disjuntas
Some Properties of Disjoint Sums of Tensors Related to Matrix Multiplication, de Francesco Romani, apareció en revista en mayo de 1982 7. La tesis sitúa el hito en 1981 y muestra 2.517. El resumen del editor confirma un enfoque basado en los rangos de potencias de una suma disjunta y en una ecuación trascendente, pero no presenta la ecuación completa. El original escaneado no pudo leerse aquí. Por ello, 2.517 sigue siendo una entrada de la figura histórica cuya construcción exacta no se reconstruye de forma independiente en este artículo.
La cuestión matemática puede explicarse sin inventar la demostración de Romani. Si S y T representan tareas independientes, entonces
Esta es una identidad distributiva general, no la supuesta ecuación optimizada del artículo inaccesible. Las posiciones del tensor codifican la elección de S o T. Para cada frecuencia hay un número binomial de palabras, y una dimensión de producto depende exponencialmente de esa frecuencia. Al crecer N, aparece un equilibrio entre la multiplicidad y el tamaño del producto. Una ecuación con funciones exponenciales del exponente resulta natural porque ambos recursos son exponenciales antes de tomar la raíz de orden N.
La enseñanza independiente es que no se puede optimizar una suma directa examinando cada sumando de forma aislada. Las potencias contienen tipos mixtos. Una elección concreta de frecuencia puede modificar la cota de extracción asintótica, y las frecuencias de los extremos pueden comportarse de forma distinta de las equilibradas. Las formulaciones posteriores mediante entropía hacen explícito ese equilibrio.
Para la ingeniería, estas multiplicidades binomiales también son una advertencia. Una demostración puede seleccionar un tipo asintótico útil y descartar grandes regiones de una construcción intermedia. El número de productos aritméticos útiles dice poco sobre el almacenamiento o el coste de preparación de materializar literalmente esa construcción. Por tanto, el apartado conserva el hito y localiza claramente su carencia de evidencia, en lugar de atribuir a Romani una ecuación genérica de potencias tensoriales como si fuera su teorema verificado.
1981/1982 — Coppersmith y Winograd: por debajo de 2.5
El trabajo temprano de Don Coppersmith y Shmuel Winograd, On the Asymptotic Complexity of Matrix Multiplication, tiene una versión en FOCS de 1981 y una publicación en revista de 1982 8. El resumen original del editor establece ω < 2.495548, una versión más precisa del 2.496 de la tesis. También trata la aceleración. La demostración temprana completa y sus hipótesis detalladas sobre el cuerpo no fueron legibles en esta auditoría; la cota se cita con ese nivel de evidencia.
Cruzar 2.5 importa históricamente porque la reducción ya no es un pequeño refinamiento de siete frente a ocho multiplicaciones. Las herramientas anteriores —agregación, rango límite y productos simultáneos— han cambiado qué se considera un punto de partida aprovechable. Una fuente finita no tiene por qué ser una pequeña multiplicación cuadrada con una planificación recursiva transparente.
Puede cuantificarse lo que implicaría una construcción base local sin afirmar que se reproduce la suya. Si una identidad de orden b tiene r productos y una preparación cuadrática fija, entonces
Así, un r inferior a b elevado a 5/2 cruzaría 2.5 en ese modelo. Un teorema de aceleración o de extracción asintótica puede establecer una cota sin presentar exactamente esta pequeña identidad finita. Confundir ambas vías oculta dónde intervienen las constantes y los argumentos de límite.
Del mismo modo, una limitación demostrada para un marco de aceleración especificado no es una cota inferior incondicional de ω. Un teorema sobre una base fija, una familia restringida de tensores o un procedimiento de extracción seleccionado no puede excluir algoritmos ajenos a esa clase. Esta distinción resulta esencial al interpretar las barreras posteriores del método láser. Un método puede ser incapaz de alcanzar dos mientras el exponente verdadero sigue siendo desconocido.
La consecuencia práctica no es que toda construcción con exponente inferior a 2.5 sea, por definición, inutilizable. Es que su implementación no puede juzgarse solo por el exponente. Un revisor necesita un algoritmo finito explícito, control de los coeficientes, restricciones de forma y una planificación antes de evaluar cualquier afirmación sobre tiempo de ejecución o comportamiento numérico.
1986 — Strassen: la perspectiva láser
El trabajo posterior de Strassen introduce una perspectiva de extracción basada en tensores, en lugar de otra versión de su identidad de siete productos 9. El trabajo de conferencia debe distinguirse de los desarrollos relacionados publicados en revista en 1987 y 1988. La reconstrucción legible de CW1990 da, para la construcción correspondiente,
Para q=5 se obtiene
Estas fórmulas se atribuyen a la reconstrucción original de CW, sin presentarlas como una lectura independiente de la demostración inaccesible de 1986 10. El denominador cuatro registra el contenido productivo simultáneo de la construcción. Eliminarlo hace perder la ganancia; interpretarlo como cuatro copias gratuitas sin verificar la extracción inventaría una.
La metáfora del láser se refiere a conservar componentes seleccionados de grandes potencias tensoriales y anular las variables incompatibles. Un tensor se divide en bloques. Las potencias tensoriales crean secuencias de bloques. Al elegir frecuencias e imponer compatibilidad, se extrae una suma directa cuyos sumandos tienen estructura de multiplicación de matrices. El bajo rango frontera de la fuente paga por todos ellos conjuntamente.
Se pasa de la pregunta local «¿cuántos productos forman una pequeña multiplicación de matrices?» a «¿cuánta multiplicación puede aislarse de una fuente estructurada?». Los productos seleccionados pueden ser rectangulares y convertirse en cuadrados solo tras una combinación cíclica. El volumen, la multiplicidad y la simetría interactúan ahora. Los conjuntos libres de progresiones del siguiente apartado ofrecen una forma de evitar las colisiones que, de otro modo, acoplan esos productos seleccionados.
La distancia de ingeniería respecto a un microkernel finito crece en consecuencia. Un componente tensorial puede ser útil por lo que contienen sus potencias de orden muy elevado, no porque el componente por sí solo sea una operación deseable en una CPU. Aun así, el razonamiento introduce un hábito duradero del análisis de rendimiento: distinguir el trabajo productivo de la interferencia y contabilizar el coste de aislar la parte productiva.
1990 — Coppersmith–Winograd: progresiones aritméticas y potencias estructuradas
Matrix Multiplication via Arithmetic Progressions combina un tensor de bajo rango frontera con extracción combinatoria 10. El artículo en revista apareció en 1990; las versiones anteriores como informe y trabajo de conferencia explican las fechas de finales de los años ochenta. El resumen redondea a 2.376, mientras que el §8 da ω < 2.375477. El 2.3755 de la tesis es un redondeo conservador, no un teorema distinto.
Para q positivo, la conocida forma CW puede escribirse como
Agrupemos cada modo en los niveles 0,1,2: la coordenada 0; las coordenadas de 1 a q; la coordenada q+1. Los componentes no nulos tienen índices de nivel cuya suma es dos. Esta estructura del soporte, definida por la suma de niveles, persiste al tomar potencias tensoriales, donde las sumas de niveles coordenada a coordenada organizan los componentes. Coexisten un rango frontera reducido y un soporte rico; el análisis de extracción aprovecha ambos.
¿Por qué progresiones aritméticas? Un esquema de hashing asigna etiquetas relacionadas por una relación lineal. Restringir las etiquetas a un conjunto sin progresiones no triviales de tres términos ayuda a forzar que las coincidencias que sobreviven tengan la etiqueta común deseada. También deben eliminarse las colisiones y las variables compartidas. Una condición de ausencia de progresiones no es, por sí sola, una demostración completa de suma directa, pero permite conservar muchas elecciones compatibles sin mantener ternas no deseadas.
Para una palabra de N elecciones de componentes con frecuencias P(s), el número de tales palabras es un coeficiente multinomial:
para un soporte finito fijo S y frecuencias enteras. El resto logarítmico depende de ese soporte fijo. La entropía mide la multiplicidad exponencial. No mide el desorden del hardware ni los bytes transferidos. Las dimensiones de los productos que sobreviven y el rango de la fuente también son exponenciales en N, de modo que tomar logaritmos produce un problema de optimización sobre distribuciones.
El logro duradero es el tensor fuente junto con un marco para analizar sus potencias. Las reducciones posteriores suelen conservar la fuente y mejorar cuánto valor puede extraerse de ella. La discusión del artículo en revista ya advierte de parámetros imprácticos; no proporciona ninguna medida moderna del umbral de rentabilidad. La meseta de veinte años posterior a este trabajo corresponde a la cota superior conocida, no demuestra que la ingeniería práctica de GEMM dejara de mejorar.
2010 — Stothers: cuartas potencias y distribuciones compatibles
La tesis de Andrew James Stothers en Edimburgo analiza potencias superiores de la construcción CW 11. Su análisis de la cuarta potencia mejora la cota que se había mantenido durante años. El artículo posterior con A. M. Davie establece ω < 2.373689703 y atribuye la mejora al trabajo de 2010 12. El valor 2.3737 de la tesis es un resumen histórico conservador. La tesis y la publicación en revista son dos registros de un mismo avance, no dos reducciones independientes.
Elevar a la cuarta potencia no basta por sí solo. Un producto tensorial multiplica la cota elemental del rango del mismo modo que multiplica las componentes disponibles. La mejora debe proceder de aprovechar mejor la estructura de las componentes agrupadas. Las potencias superiores revelan tipos de componentes cuyo valor no se capta al tratar cada elección básica de forma independiente.
Una cuestión concreta del análisis de Davie–Stothers es la fibra de compatibilidad: varias distribuciones sobre clases de componentes tienen las mismas tres distribuciones marginales de coordenadas. Su organización de la cuarta potencia contiene diez clases de simetría y dos grados de libertad en las restricciones marginales. El artículo obtiene ecuaciones ponderadas de estacionariedad de la entropía, entre ellas
Estas variables b utilizan los pesos de clase definidos en ese artículo; no son probabilidades arbitrarias sin ponderar. Las ecuaciones muestran que los parámetros numéricos deben satisfacer restricciones estructurales. Elegir diez valores atractivos no define, por sí solo, una construcción láser válida.
Un ejemplo independiente más pequeño aclara por qué la información marginal puede ser insuficiente. Consideremos la distribución conjunta
Todas las distribuciones marginales por filas y columnas son (1/2,1/2), pero
Su máximo es log 4 cuando x=1/4; cuando x=0 vale log 2, con la convención 0 log 0=0. Por tanto, unas marginales iguales no implican el mismo número de palabras conjuntas a escala exponencial. Esta es una ilustración abstracta de probabilidad, no una sustitución de la construcción de diez clases del artículo. Permite aislar el motivo por el que puede ser importante optimizar la entropía entre tipos conjuntos compatibles.
La analogía con la ingeniería es limitada, pero útil: los recuentos agregados de utilización pueden ocultar qué operandos deben coexistir. Aquí la compatibilidad es una restricción algebraica, no un modelo de caché. La mejora matemática procede de comprender ese acoplamiento oculto en una potencia superior, no de una nueva planificación de memoria medida experimentalmente.
2012 — Vassilevska Williams: análisis sistemático de potencias superiores
Virginia Vassilevska Williams desarrolla herramientas para automatizar el análisis de potencias mayores y de las restricciones entre sus componentes 13. La afirmación 2.3727 del resumen del congreso se corrigió posteriormente. El manuscrito extenso de la autora, de julio de 2014, identifica expresamente el error y establece ω < 2.372873; su conclusión conservadora para la octava potencia es ω < 2.3729 14. Repetir el resumen original sin esa corrección daría una imagen engañosa de la cronología.
El avance central es un procedimiento de análisis sistemático. Una potencia contiene muchos tipos de componentes. Algunas son multiplicaciones de matrices inmediatas; otras necesitan una cota inferior recursiva de su valor. Estas cotas alimentan la optimización restringida del siguiente nivel. La tarea se convierte en una jerarquía de análisis de componentes, en lugar de una única búsqueda de una identidad de r productos.
La dirección lógica es importante. Un vector de parámetros factible y unas cotas inferiores válidas para los valores de las componentes establecen una desigualdad suficiente para obtener una cota superior de ω. Que un optimizador no encuentre un punto mejor no demuestra que el óptimo verdadero sea peor ni establece una cota inferior de ω. Las tolerancias de las restricciones, la normalización, los casos límite con probabilidad cero y la precisión aritmética afectan a si un candidato calculado certifica realmente la desigualdad deseada.
Como criterio suficiente genérico, sea L(ρ,θ) una cota inferior rigurosamente justificada del valor productivo de una potencia tensorial, con parámetros admisibles θ, y sea rᴷ su presupuesto de rango frontera. Entonces
bajo la convención de valor y el teorema de extracción elegidos. Este esquema describe la estructura de la demostración; no es un teorema nuevo que sustituya las restricciones de la fuente. El conjunto F de parámetros factibles forma parte de las matemáticas. Un punto fuera de F, por impresionante que sea el valor de su función objetivo, no demuestra nada sobre el exponente.
El resultado corregido también ofrece una lección metodológica. La precisión bibliográfica incluye las versiones de los manuscritos, no solo el autor y el año. El 2.3729 redondeado de la tesis evita conservar la cifra errónea del anuncio, mientras que el análisis detallado debe explicar al lector por qué discrepan los registros disponibles. La búsqueda matemática asistida por software necesita entradas versionadas y resultados auditables, igual que los experimentos de rendimiento necesitan kernels y configuraciones versionados.
2014 — Le Gall: valor, brechas de entropía y subproblemas convexos
Powers of Tensors and Fast Matrix Multiplication, de François Le Gall, proporciona un método general de optimización y alcanza ω < 2.3728639 15. Su análisis combinado utiliza potencias hasta la 32. El pequeño cambio decimal oculta una contribución algorítmica importante: parte del análisis puede organizarse como optimización convexa, en lugar de depender exclusivamente de una búsqueda numérica no convexa sin control.
Para precisar el resultado, utilizaremos la convención de valor de Le Gall. Sean Tᶜ y Tᶜᶜ permutaciones cíclicas de los grupos de variables. Para 2 ≤ ρ ≤ 3, el valor asintótico se define a partir de las extracciones
El máximo se toma sobre las extracciones permitidas; la definición asintótica es la de la fuente. La simetrización cíclica y el factor tres mantienen ρ en unidades del exponente cuadrado. Parte de la bibliografía posterior denomina a su parámetro ρ/3. No se pueden comparar valores entre esas convenciones sin convertirlos.
Para una descomposición de soporte ajustado con componentes Tₛ y una distribución P sobre el soporte S, el Teorema 4.1 establece
donde P₁,P₂,P₃ son las distribuciones marginales de coordenadas y
Debe utilizarse una base de logaritmos coherente; este artículo utiliza logaritmos naturales. Un soporte ajustado significa que, en la descomposición considerada, los índices de las componentes están en un plano de suma de coordenadas constante. Estas hipótesis son importantes. La fórmula no es una cota de entropía para particiones arbitrarias sin relación entre sí.
Las tres primeras entropías marginales representan las palabras de coordenadas disponibles. Los valores de las componentes contabilizan el trabajo productivo dentro de un bloque conservado. La brecha de entropía no negativa penaliza la ambigüedad entre tipos conjuntos con esas marginales. En la ilustración anterior de dos por dos, esa brecha sería log 4−H(Pₓ); solo se anula en el acoplamiento compatible de máxima entropía. La ilustración explica la penalización, pero no satisface por sí sola todas las hipótesis tensoriales del teorema.
El Algoritmo A de Le Gall optimiza primero una expresión cóncava y después elige una distribución de máxima entropía en la fibra de marginales fijas. Esto proporciona una cota inferior certificada, no una solución global de cualquier formulación no convexa. El artículo utiliza además un Algoritmo B distinto para afinar el análisis de la octava potencia y luego lo amplía a las potencias 16 y 32. La explicación completa es más específica que «la optimización convexa resolvió la multiplicación de matrices».
Para q=5, el presupuesto de rango en la potencia 32 es 7³². La Tabla 5 presenta un excedente positivo de la cota inferior para ρ=2.3728639. La estimación inferior negativa que muestra para un ρ ligeramente menor no demuestra que no exista una construcción factible más fuerte. Una estimación inferior que no alcanza un umbral puede ser inconcluyente. Esta distinción entre un certificado suficiente y una búsqueda fallida seguirá siendo central en los artículos de optimización de 2026.
2020/2021 — Alman y Vassilevska Williams: extracción refinada
A Refined Laser Method and Faster Matrix Multiplication, de Josh Alman y Virginia Vassilevska Williams, se anunció en 2020, se publicó en SODA 2021 y apareció posteriormente en TheoretiCS en 2024 16. Establece ω < 2.3728596 con algoritmos sobre cualquier cuerpo. Esas fechas describen versiones de un mismo avance.
El refinamiento mejora la garantía para extraer componentes disjuntas utilizables de un tensor particionado. No sustituye la fuente CW por un nuevo kernel pequeño de GEMM denso. Su aplicación final estudia la potencia 32 de CW₅ y establece el excedente requerido del valor frente al rango. En la normalización del exponente cuadrado utilizada anteriormente, la comparación decisiva es
La fuente escribe el parámetro del valor dividido por tres en su propia convención. La conversión realizada aquí es deliberada. Citar su símbolo de valor con la convención del exponente de este artículo, pero sin modificar el parámetro, introduciría un error de un factor tres.
¿Por qué puede un refinamiento superar un análisis anterior de la misma potencia? El presupuesto de rango del tensor fuente no cambia, pero puede aumentar la cantidad de trabajo que se demuestra que puede extraerse simultáneamente. Las cotas anteriores pueden descartar demasiadas componentes candidatas para imponer independencia. Una contabilidad combinatoria más precisa puede reducir esa pérdida sin cambiar la fuente algebraica. El decimal resultante refleja una cota inferior más fuerte del valor, no una reducción del rango frontera ya conocido del tensor.
En este punto, la optimización matemática tiene varias capas: elegir distribuciones, acotar los valores de las componentes, contabilizar las colisiones y comparar con el presupuesto de la fuente. Una heurística puede ayudar a encontrar parámetros, pero el teorema de extracción determina qué significan esos parámetros. Esta distinción también explica por qué una mejora muy pequeña puede exigir una demostración sustancialmente nueva y no solo más iteraciones del optimizador.
La implicación para la ingeniería es indirecta. La demostración mejora la teoría de existencia de la multiplicación exacta. No especifica un punto de cruce práctico, una constante de error numérico ni una planificación de ejecución en GPU. Eso requiere una construcción finita y mediciones con precisión y dimensiones declaradas explícitamente. La contribución debe valorarse en sus propios términos matemáticos antes de extraer conclusiones sobre sistemas.
2022/2023 — Duan, Wu y Zhou: hashing asimétrico
Faster Matrix Multiplication via Asymmetric Hashing, de Ran Duan, Hongxun Wu y Renfei Zhou, cambia la forma en que la extracción trata la pérdida por combinación 17. La primera versión es de 2022; las revisiones iniciales examinadas indican 2.37188. La mejora ω < 2.371866 aparece en la revisión de abril de 2023 y en el registro de FOCS 2023. Por eso un punto de 2022 que lleve los dígitos posteriores necesita una nota sobre la versión.
La pérdida por combinación aparece cuando componentes útiles por separado se agrupan en un nivel superior, pero no es posible conservar conjuntamente todas sus elecciones internas. Contar de forma independiente el mejor valor posible de cada componente puede sobreestimar el total compatible. A la inversa, imponer un tratamiento simétrico uniforme puede descartar combinaciones válidas. El artículo utiliza hashing asimétrico para recuperar valor que se pierde en los análisis anteriores; la construcción presentada utiliza una octava potencia.
Un recuento genérico ilustra el problema sin reproducir la construcción del artículo. Supongamos que hay M subproblemas candidatos disponibles localmente, pero la compatibilidad conserva solo K tras imponer una condición global de coherencia. La multiplicidad útil es K, no M. Si M y K crecen exponencialmente con la potencia tensorial N, su cociente aporta una penalización no nula en la tasa de entropía:
Si esa expresión tiende a una constante positiva, persiste en el límite asintótico. En cambio, una pérdida de poda de un factor constante desaparece al dividir por N. Esta distinción explica por qué corregir una pérdida combinatoria puede mejorar un exponente, mientras que ahorrar un número fijo de operaciones de preparación no puede hacerlo.
El artículo también analiza una barrera de aproximadamente 2.3725 para un método anterior restringido. Esa barrera no es una cota inferior de ω. Indica que un análisis o marco de extracción concreto no puede certificar más allá de su límite bajo sus hipótesis. La construcción asimétrica cambia el marco, de modo que superar esa barrera es compatible con el teorema que la establece.
Para la ingeniería, la lección está en la contabilidad: los óptimos locales no siempre pueden componerse en un óptimo global. Esto no afirma que el hashing sea la optimización que le falta a un kernel de GEMM. Aquí las funciones hash imponen independencia algebraica entre palabras tensoriales; no son una instrucción para aplicar hashing a las matrices durante la ejecución y obtener la aceleración asintótica publicada.
2024 — Vassilevska Williams, Xu, Xu y Zhou: distribuciones completas de partición
New Bounds for Matrix Multiplication: from Alpha to Omega, de Virginia Vassilevska Williams, Yinzhan Xu, Zixuan Xu y Renfei Zhou, aparece en SODA 2024 tras un preprint de 2023 18. Su teorema para matrices cuadradas establece ω ≤ 2.371552. Aquí se conserva la desigualdad no estricta. El artículo también mejora cotas rectangulares y establece α ≥ 0.321334; son afirmaciones distintas.
El análisis conserva distribuciones completas de partición, que registran información hasta los bloques de nivel uno, en lugar de limitarse a un solo paso recursivo. Una marginal gruesa puede ocultar varias formas de realizar una componente de nivel superior. Conservar la partición completa de los niveles inferiores puede impedir que el análisis trate realizaciones incompatibles como si fueran intercambiables.
La información adicional tiene un coste. Los tres grupos de variables del tensor deben satisfacer condiciones de coherencia, y algunas variables faltan después de las restricciones: se describen como huecos en la construcción. Una extracción válida debe reparar esos huecos o contabilizarlos. Añadir restricciones no mejora automáticamente una función objetivo; puede revelar un sobreconteo anterior. La mejora procede de organizar la construcción de modo que la contabilidad más exigente siga siendo productiva.
En una distribución jerárquica esquemática, sea s una componente gruesa y u su partición interna. La ley conjunta es
Esta identidad estándar ilustra la información que se descarta al conservar únicamente P(s). No es el sistema completo de factibilidad del artículo. Las distribuciones condicionales también deben ser coherentes con las particiones de los grupos de variables y con la estructura tensorial recursiva. Tratarlas como variables independientes sin restricciones produciría un beneficio de entropía injustificado.
Los resultados rectangulares refuerzan una distinción importante entre las dimensiones teóricas y las prácticas. La teoría caracteriza cómo escalan las dimensiones como potencias de n, mientras que las bibliotecas optimizan ternas finitas (m,k,n). Ambas necesitan información sobre las dimensiones, pero una mejora en α no predice la latencia de una matriz de atención concreta. Una afirmación sobre sistemas sigue necesitando el tipo de datos, la disposición en memoria, el tamaño del lote, el hardware y una ruta de ejecución medida.
2024/2025 — Alman y colaboradores: más asimetría
More Asymmetry Yields Faster Matrix Multiplication, de Josh Alman, Ran Duan, Virginia Vassilevska Williams, Yinzhan Xu, Zixuan Xu y Renfei Zhou, se anunció en 2024 y se publicó en SODA 2025 19. Su resultado histórico es ω < 2.371339. Una revisión posterior de 2026 incorpora una optimización más reciente, por lo que un resumen actual sin una versión fijada no permite establecer qué dígitos corresponden a 2024.
La construcción relaja un requisito anterior de tratar dos dimensiones de forma idéntica en el análisis. Esto amplía el espacio de diseño admisible y conserva los requisitos globales necesarios para recuperar la multiplicación de matrices cuadradas. No significa que la simetría desaparezca en todas partes ni que el producto cuadrado final se convierta en rectangular.
Una analogía con la optimización restringida aclara la ganancia lógica. Si Fsym es el subconjunto de elecciones de parámetros factibles que satisfacen una condición adicional de simetría, entonces
Esta inclusión, por sí sola, no demuestra una mejora estricta: todavía hay que aportar una construcción factible mejor. Tampoco se pueden eliminar restricciones de compatibilidad simplemente para ampliar el dominio de búsqueda. La libertad relevante es la que justifica la construcción tensorial, seguida del equilibrado necesario de los tres papeles.
La secuencia histórica tiene ya una estructura clara. Las potencias superiores revelaron más tipos de componentes; la extracción refinada redujo pérdidas; el hashing asimétrico cambió la contabilidad de la compatibilidad; las distribuciones completas de partición conservaron más estructura interna; una mayor asimetría eliminó una restricción innecesaria. Son avances matemáticos distintos, aunque los exponentes publicados solo difieran en decimales posteriores.
Desde el punto de vista de la implementación, ampliar el espacio de parámetros no produce automáticamente un kernel manejable. La fuente, la descomposición recursiva y la extracción siguen siendo objetos asintóticos. Su relevancia para la ingeniería del rendimiento está en demostrar la importancia de modelar y verificar cuidadosamente las restricciones, no en ofrecer un resultado de benchmark para un procesador o una carga de inferencia.
Más allá de la cronología de la tesis: investigación difundida en 2026
Los siguientes resultados se examinaron hasta el 22 de noviembre de 2026. Se presentan por separado de la cronología anterior de congresos y revistas porque difieren las pruebas disponibles y el estado de publicación. Los manuscritos primarios permiten conocer qué afirman sus autores y aportan argumentos o artefactos; leer esos artefactos no equivale a reproducir o aceptar las demostraciones. En los registros primarios examinados no se estableció una publicación con revisión por pares para ninguno de los seis registros de 2026 tratados aquí.
Dupont y colaboradores: optimización moderna y AlphaEvolve
Improving the matrix multiplication exponent with modern optimization and AlphaEvolve presenta ω < 2.371177 20. El preprint de agosto de 2026 conserva el marco de pérdida por combinación y reformula la búsqueda de parámetros. Su problema de nivel cuatro tiene aproximadamente siete millones de parámetros de optimización. Esos parámetros describen una construcción asintótica; no son los pesos de un kernel matricial pequeño ni de un benchmark de hardware.
El procedimiento separa el marco matemático, la búsqueda numérica y la verificación rigurosa. La optimización paralela diferenciable y un optimizador evolucionado ayudan a localizar un candidato. A continuación, el artículo analiza el uso de aritmética racional y cotas exteriores de los logaritmos para certificar las desigualdades. Un valor de la función objetivo en coma flotante sería insuficiente por sí solo, especialmente cuando el margen entre dos exponentes propuestos es pequeño.
Aquí aparece un principio útil de análisis numérico. Sea g(θ,ρ)>0 un margen suficiente de factibilidad. Si una evaluación aproximada devuelve un número positivo menor que su cota de error, se desconoce el signo. Un certificado válido necesita un intervalo que encierre el valor y cuyo extremo inferior sea positivo. La búsqueda puede utilizar aritmética aproximada rápida; el argumento final debe acotar todas las restricciones y funciones objetivo relevantes en la dirección requerida. Esta es una explicación genérica de la certificación, no una reproducción del certificado del preprint.
En la versión examinada, los autores indican que están preparando el repositorio con la solución y el código de verificación. No identifiqué una publicación mantenida por los autores ni volví a ejecutar esa verificación. La descripción adecuada es la de un preprint que presenta un resultado de optimización comprobado rigurosamente, con sus límites de disponibilidad y reproducción declarados de forma explícita. Las hipótesis sobre el cuerpo del marco anterior siguen siendo relevantes; la ω sin especificar de la nota no debe convertirse silenciosamente en un teorema nuevo sobre un cuerpo concreto en este artículo.
Zadeh: una búsqueda estructurada y un certificado exacto
A faster matrix multiplication algorithm through structured optimization, de Reza Zadeh, establece en su Teorema 1
y extiende la construcción a extensiones de característica cero, incluidas R y C 21. Los parámetros recursivos compartidos y el condicionamiento dependiente de la masa estructuran la búsqueda. Las 212,820 coordenadas del optimizador declaradas no deben confundirse con la dimensión de un espacio factible completamente libre.
La implicación del certificado del preprint tiene la forma
Aquí C, la cantidad de entropía certificada con acento circunflejo y M son las cantidades que construye la fuente para unos parámetros admisibles. Sus definiciones y condiciones de factibilidad forman parte del teorema; la desigualdad no permite elegir tres escalares arbitrarios. El artículo encierra la expresión calculada de la cota superior en
Este intervalo encierra una expresión del certificado, no el valor verdadero y desconocido de ω. En particular, su extremo inferior no es una cota inferior del exponente de multiplicación de matrices. Esta distinción impide interpretar un intervalo numérico aparentemente muy preciso como una solución bilateral del problema abierto.
El material complementario incluye datos racionales y un verificador basado en la biblioteca estándar. El artículo distingue ese certificado asistido por ordenador de una formalización del argumento tensorial completo mediante un asistente de demostración. No he ejecutado el verificador. Un comprobador implementado de forma independiente, una ejecución reproducida, una auditoría experta del teorema de reducción y una publicación con revisión por pares son formas de evidencia distintas. La afirmación explícita del preprint sobre el cuerpo de los racionales también es más acotada y más informativa que un titular sin matices que diga «funciona en todas partes».
OpenAI: por debajo de 2.258 y una afirmación de 9/4 sobre el cuerpo de los complejos
Dos publicaciones oficiales de investigación requieren un tratamiento separado. El manuscrito del 24 de septiembre, Complex Matrix Multiplication Below 2.258 and Rectangular Bounds, afirma una cota estricta para el caso cuadrado complejo inferior a 1129/500=2.258, junto con resultados duales y rectangulares 23. Sus corolarios de transferencia entre cuerpos distinguen la característica cero, todas las características positivas salvo un número finito y la afirmación dual. El enunciado examinado no enumera las características excepcionales.
El manuscrito del 2 de octubre, An Upper Bound of 9/4 for the Matrix Multiplication Exponent, afirma
Su mecanismo no es otro ajuste de la función objetivo de CW 22. Utiliza un separador de un grupo de variables compartido, caracteres tensoriales, perfiles de multiplicación polinómica y crecimiento discreto. El siguiente esquema recoge la estructura del argumento publicado; no es una verificación independiente de la demostración.
Para una suma emparejada A de M componentes que comparten el grupo de variables X, el separador establece
El tensor Bₓ(M) es un tensor auxiliar de producto escalar que comparte el papel indicado. Hay M bloques de salida con una dimensión auxiliar M, no M² bloques de salida completos e independientes. Es esencial contabilizar las 5M copias de la fuente. La relación de Fourier y los pesos de la degeneración están diseñados para conservar las etiquetas emparejadas y eliminar las que no coinciden.
Para un carácter tensorial λ con λ(Bₓ(m))=m elevado a pₓ, el recuento de tipos produce una desigualdad de entropía. Si q es una distribución sobre componentes emparejadas,
Aquí un carácter es un funcional escalar normalizado que respeta la suma y el producto de tensores y el orden correspondiente, no un autovalor de una matriz. Forma parte de un argumento espectral asintótico. El factor de entropía procede de la multiplicidad multinomial, con el coste de las copias del separador incluido antes de tomar el límite.
El tensor polinómico y su rango exacto se escriben
Sobre C, la evaluación y la interpolación de polinomios proporcionan la cota superior del rango; la matricización de la salida proporciona la cota inferior coincidente. Al promediar sobre las seis permutaciones de los grupos de variables, con t=(pₓ+pᵧ+p_z)/3>0, se obtiene el perfil
El argumento publicado obtiene concavidad discreta y una desigualdad de triplicación con desplazamiento,
No se puede descartar el desplazamiento a−1. A partir de estas desigualdades, su argumento de crecimiento discreto obtiene
El símbolo Hₐ representa aquí una sucesión del perfil, no la entropía. Al combinar su cota inferior con la cota superior derivada del rango se obtiene
La fuente utiliza después caracteres detectores para obtener la afirmación sobre el exponente. La conversión aritmética final selecciona, para cada holgura positiva solicitada, un tamaño de bloque fijo u y un rango r con r < u elevado a 9/4+δ. La evaluación recursiva tiene la forma
Esto explica por qué el enunciado conserva ε y constantes que dependen de él. No proporciona una rutina de biblioteca eficiente y especificada con coste O(n elevado a 9/4). El grado de una degeneración fija, el límite posterior de frecuencias y la recursión final por bloques son etapas distintas; intercambiarlas sin cotas del grado y de los coeficientes sería inseguro.
Qué establecen aquí los artefactos formales
La revisión examinada del repositorio oficial incluye un módulo de solución en Lean que exporta el teorema complejo de 9/4, documentación de alcance y una configuración del comparador. El comparador enumera los axiomas fundamentales permitidos; los marcadores de posición deliberados de su archivo de desafío no son la demostración suministrada en la solución. Sería incorrecto afirmar que no existen artefactos formales. También sería incorrecto afirmar que reconstruí y comprobé de forma independiente toda su cadena de dependencias: no lo hice.
El repositorio describe material de investigación producido por modelos y distintas etapas de verificación. Esa descripción, por sí sola, ni refuta un teorema concreto ni establece la aceptación de la comunidad. Este artículo distingue cuatro observaciones: un argumento matemático publicado, código fuente formal suministrado, desarrollos matemáticos independientes posteriores y una publicación con revisión por pares. Las tres primeras cuentan aquí con registros identificables; la cuarta no quedó establecida para estas publicaciones mediante esta auditoría. Un teorema decimal independiente sobre todos los cuerpos, dentro de la misma familia formal, no debe fusionarse con el enunciado complejo de 9/4.
Desarrollos independientes posteriores: Lü y Pass
El preprint de octubre de Houxi Lü sustituye el separador de tipo Fourier por una construcción polinómica 24. Sobre un cuerpo que contenga suficientes elementos distintos, establece
Cuando n=M, el coste de la fuente se convierte en 2M−1. La sustitución utiliza evaluación de polinomios y un anillo de polinomios truncados. La consecuencia que afirma alcanza los cuerpos algebraicamente cerrados de cualquier característica. Una conclusión sobre cuerpos finitos necesita un argumento adicional de descenso. Mejorar una constante del separador y conservar su exponente de entropía no establece, por sí solo, una mejora estricta por debajo de 9/4.
El preprint separado de Rafael Pass ofrece una vía constructiva mediante empaquetado de polinomios 25. Una identidad clave es telescópica. Con longitudes de entrada debidamente acotadas y los parámetros de la fuente, se define
Entonces, la expansión directa cancela los términos internos:
Bajo su condición de tamaño ct ≥ a+2b−1, la construcción empaqueta c+1 productos completos y un producto central, no c+2 productos completos. La distinción es importante porque solo se recuperan coeficientes seleccionados del producto central. La amplificación, la separación de la entrada compartida y el equilibrado producen el umbral
Para c>1, el límite se deduce de que log(1+x) es asintótico a x. El preprint describe la construcción finita y la conversión aritmética; no he ejecutado su formalización generada. Estos son manuscritos de desarrollo matemático posterior verdaderamente independientes, por lo que sería falso afirmar que no existe seguimiento independiente. Su existencia tampoco establece la aceptación mediante revisión por pares ni la transferencia universal entre cuerpos de todos los teoremas anteriores.
Qué demuestra el método láser y qué excluye una barrera
La línea clásica del método láser puede resumirse como una cadena de desigualdades entre recursos. Se elige un tensor fuente con una expresión de bajo rango frontera. Se particionan sus grupos de variables. Se toman potencias altas. Se seleccionan tipos y se aplican hashing y poda para obtener componentes independientes. Se acota inferiormente el valor dentro de cada componente. Se aplica la desigualdad de la suma asintótica y se compara con el presupuesto de rango. Cada paso necesita sus propias hipótesis.
El análisis contiene tres pérdidas diferentes. Puede haber una pérdida de tipos cuando solo se conservan determinados patrones de frecuencia. La pérdida de compatibilidad o de combinación aparece cuando las elecciones locales no pueden realizarse conjuntamente. La pérdida por poda aparece cuando hay que eliminar colisiones o variables compartidas. Estas descripciones son conceptuales; no afirman que todos los artículos utilicen los mismos tres nombres o la misma fórmula. Su característica común es que una pérdida exponencial persiste en el límite de las potencias tensoriales.
La entropía interviene porque el número de palabras con una distribución empírica fija es exponencial en N. Las cotas del rango y los volúmenes de los productos también son exponenciales. Dividir los logaritmos por N aísla las tasas de crecimiento, mientras que los factores multiplicativos fijos desaparecen. Por eso una mejora combinatoria aparentemente pequeña puede modificar ω, y una mejora fija en el coste de asignación de memoria no puede hacerlo.
La simetría puede reducir la complejidad de la optimización, pero también restringir la construcción factible. Eliminar una simetría injustificada puede ayudar; eliminar una restricción de coherencia necesaria invalida el cálculo. Del mismo modo, optimizar una relajación puede proporcionar una cota del potencial de un método, mientras que un testigo factible proporciona una construcción real. Ambos desempeñan papeles lógicos opuestos y no deben intercambiarse.
Un teorema de barrera se aplica a un tensor fuente, una clase de degeneraciones, un funcional de valor o un método de extracción especificados. No se convierte en una cota inferior universal de la multiplicación de matrices porque se describa informalmente como «la barrera del láser». El argumento de separador y perfil de 2026 es relevante porque propone una vía distinta, no solo porque el decimal de su titular sea menor. Aceptar esa vía exige comprobar sus matemáticas y sus artefactos con el nivel de escrutinio correspondiente.
Una cronología verificada junto a la original
La tabla recoge la precisión y las fechas específicas de cada fuente. «Declarado» señala una limitación de acceso a la demostración original o una afirmación reciente; no implica silenciosamente que se hayan reproducido todos los teoremas. Los valores escalares históricos, por sí solos, no deben ordenarse en una lista universal de récords actuales sin información sobre el cuerpo y el estado del resultado.
| Avance | Cota cuadrada específica de la fuente | Fecha, versión y evidencia |
|---|---|---|
| Strassen | ω ≤ log₂7 ≈ 2.807354922 | Se leyó la identidad original de 1969. |
| Pan | inferior a 2.796; Bini indica aproximadamente 2.7951 | Congreso de 1978; aquí no se reconstruye la construcción original exacta. |
| Bini, Capovani, Romani, Lotti | log₁₂1000 ≈ 2.779885224 | Construcción aproximada de 1979; el paso asintótico exacto se cita por separado. |
| Schönhage | inferior a 3 log52/log110 ≈ 2.521812715 | Resumen de revista de 1981; se leyó el teorema de la suma mediante la reconstrucción de CW. |
| Romani | 2.517 en la figura original de la tesis | Metadatos de revista de 1982 verificados; sigue sin haber acceso a la cota precisa y su demostración. |
| Coppersmith–Winograd, primeros trabajos | ω < 2.495548 | FOCS 1981 / resumen de revista de 1982. |
| Strassen, método láser | ω ≤ log₅54 ≈ 2.478495141 | FOCS 1986; se leyó la reconstrucción primaria de CW. |
| Coppersmith–Winograd | ω < 2.375477 | Revista de 1990, §8; congreso anterior de 1987. |
| Stothers | ω < 2.373689703 | Tesis de 2010 / publicación de Davie–Stothers de 2013. |
| Vassilevska Williams | ω < 2.372873; por tanto, <2.3729 | Trabajo de 2012; manuscrito de la autora corregido en julio de 2014, no el resumen erróneo con 2.3727. |
| Le Gall | ω < 2.3728639 | ISSAC 2014; análisis combinado hasta la potencia 32. |
| Alman–Vassilevska Williams | ω < 2.3728596 | Preprint de 2020 / SODA 2021 / revista de 2024. |
| Duan–Wu–Zhou | ω < 2.371866 | Revisión de 2023 / FOCS; las versiones iniciales de 2022 indicaban 2.37188. |
| Vassilevska Williams–Xu–Xu–Zhou | ω ≤ 2.371552 | Preprint de 2023 / SODA 2024. |
| Alman–Duan–Vassilevska Williams–Xu–Xu–Zhou | ω < 2.371339 | Anuncio de 2024 / SODA 2025, con la versión histórica fijada. |
| Dupont et al. | ω < 2.371177 declarado | Preprint de agosto de 2026; aquí no se reprodujo el certificado. |
| Zadeh | ω_Q < 2.37115924 declarado | Preprint de octubre de 2026 con certificado racional; aquí no se reprodujo. |
| OpenAI, septiembre | ω_C < 2.258 afirmado | Publicación de investigación de septiembre de 2026; corolarios de transferencia entre cuerpos específicos de la fuente. |
| OpenAI, octubre | ω_C ≤ 9/4 afirmado | Publicación de investigación de octubre de 2026 con código fuente formal; aquí no se realizó una reproducción completa. |
| Lü; Pass | vías posteriores hacia 9/4 con los alcances declarados | Preprints de octubre de 2026; no son mejoras decimales estrictas adicionales. |
Dos comparaciones ayudan a interpretar la escala. Una diferencia Δ entre exponentes solo aporta un factor n elevado a Δ si todos los demás costes y constantes se mantienen iguales, algo que estos artículos no prometen. Además, cambiar el cuerpo o el estado de la demostración cambia lo que se compara. Una gráfica histórica es útil para orientarse; el teorema, la versión y el modelo aritmético que la acompañan contienen el significado científico real.
Por qué un exponente menor puede perder en tamaños prácticos
Una cota asintótica compara el crecimiento después de absorber todas las constantes fijas. Una máquina ejecuta esas constantes. Entre ellas se encuentran las combinaciones lineales, el empaquetado, la asignación de memoria de trabajo, la sincronización, el manejo de coeficientes, el relleno, los casos de borde y las instrucciones que no realizan las multiplicaciones escalares contabilizadas. Un teorema puede ser correcto mientras que una implementación directa resulte lenta para cualquier dimensión que quepa en el hardware disponible.
Un modelo deliberadamente sencillo del umbral de rentabilidad permite cuantificar la cuestión. Supongamos que una multiplicación cuadrada clásica optimizada tarda a n³ segundos y que un nivel de Strassen utiliza siete casos base clásicos de la mitad de tamaño, más b n² segundos de trabajo adicional. Supongamos que a y b son coeficientes positivos fijos en el intervalo de interés y que b incluye todos los costes adicionales pertinentes. Entonces
y el modelo predice una ventaja únicamente si
Esta es una desigualdad ilustrativa, no un umbral de rentabilidad medido. En la práctica, a cambia cuando los casos base dejan de saturar las unidades vectoriales o cruzan límites de caché; b cambia con la fusión, la disposición de datos y el número de hilos. Un modelo que los trate como constantes debe validarse en una región especificada. Una recursión más profunda reduce las multiplicaciones escalares, pero puede aumentar el peso de las sumas y volver ineficientes los casos base.
La misma cuestión aparece en el paralelismo. Siete tareas pueden ofrecer concurrencia, pero sus tamaños, las actualizaciones compartidas de la salida y la memoria de trabajo pueden limitar la planificación. Si el kernel del caso base ya utiliza todos los núcleos, otro nivel de paralelismo de tareas puede sobresuscribirlos. En una GPU pueden dominar los lanzamientos, la sincronización y los bloques pequeños. Ningún teorema sobre el exponente establece que una correspondencia arbitraria con el hardware lo utilice de forma eficiente.
El relleno es otra constante oculta. Rellenar n hasta p<2n conserva el exponente, pero, cerca de un límite entre potencias de dos, p puede ser casi el doble de n. La aritmética y el almacenamiento con relleno difieren entonces considerablemente de los de una implementación adaptada a la forma. Una demostración matemática utiliza el relleno para establecer la existencia de un algoritmo para todo n; una biblioteca puede elegir un algoritmo finito distinto para cada clase de formas.
La estabilidad numérica requiere un teorema independiente
Las identidades exactas solo siguen siendo exactas en su dominio aritmético. Para la aritmética con redondeo, supongamos el modelo relativo estándar de una operación elemental, con unidad de redondeo u, sin desbordamiento ni efectos de subdesbordamiento que invaliden el modelo:
Para un producto escalar secuencial convencional con productos y sumas redondeados por separado, el desarrollo de los factores de perturbación da la conocida comparación por componentes
Los valores absolutos del miembro derecho se aplican entrada a entrada y después se realiza una multiplicación matricial ordinaria no negativa. Esta cota corresponde a C=AB bajo el modelo indicado; la conversión de entradas, el escalado α/β, la precisión mixta y un algoritmo de suma distinto requieren sus propios análisis. Una FMA modifica la secuencia de redondeos. La cantidad u es la unidad de redondeo y no coincide automáticamente con lo que un lenguaje de programación denomina épsilon de máquina.
Strassen forma primero sumas y diferencias, las multiplica y después resta resultados intermedios. Esas combinaciones lineales cambian la propagación del error. Un valor intermedio pequeño puede resultar de la cancelación de términos mucho mayores; puede tener un error relativo grande aunque su error absoluto esté controlado. Un AB final pequeño también puede volver poco informativa una cota de error relativa a la norma del producto. La cancelación simbólica exacta no implica una cancelación sin error en coma flotante.
Demmel, Dumitriu, Holtz y Kleinberg establecen resultados de estabilidad hacia delante en norma para la multiplicación rápida 30. Sus cotas tienen la forma
con una norma especificada y un factor μ(n) que depende del algoritmo. El artículo distingue esta propiedad de la cota clásica por componentes, que es más fuerte. No afirma estabilidad hacia atrás universal, constantes idénticas a las de GEMM clásico ni un error relativo pequeño medido respecto de un AB con cancelación. Tampoco valida cualquier implementación o profundidad de recursión.
En una evaluación numérica hay que probar escalas, cancelación, patrones aleatorios y adversos, profundidad de recursión y precisión de los casos base. Deben comunicarse tanto un residuo normalizado por las normas de las entradas como la tolerancia prevista para la aplicación. Las pruebas exactas con enteros y Fraction son adecuadas para el ejemplo algebraico de este artículo, pero no pueden sustituir las pruebas de estabilidad en coma flotante. A la inversa, comparar un resultado en coma flotante con una única salida de referencia no puede demostrar una identidad bilineal general.
La inferencia cuantizada añade otra distinción. Los productos INT8 con un acumulador más ancho solo pueden implementar aritmética entera exacta dentro de sus hipótesis de rango. Las sumas de operandos de Strassen amplían el rango de entrada, y los productos intermedios o sus recombinaciones pueden desbordarse incluso cuando el resultado clásico final cabría. La saturación, la recuantización y la gestión del punto cero cambian el álgebra. Una identidad sobre un anillo sin límites de rango no puede trasladarse sin cambios a aritmética con saturación.
Jerarquía de memoria, intensidad aritmética y comunicación
El modelo Roofline relaciona el rendimiento alcanzable con un techo de cómputo y el suministro de datos en un límite de memoria identificado 26. Si Ppeak se mide en operaciones por segundo, B es el ancho de banda sostenible en bytes por segundo e I son las operaciones por byte transferido en ese mismo límite, entonces
Se trata de una cota, no de una promesa de alcanzarla. La mezcla de instrucciones, las dependencias, la ocupación vectorial, la latencia y la concurrencia pueden imponer techos inferiores. La intensidad medida en DRAM no puede combinarse indiscriminadamente con el ancho de banda de L1. Un kernel puede estar limitado por cómputo respecto a DRAM y, aun así, estar limitado por el suministro de operandos más cerca de las unidades de ejecución.
Deduzcamos un ejemplo a nivel de panel. Se actualiza un bloque C de tamaño b×b con una A de forma b×k y una B de forma k×b. Supongamos que C permanece en el lado rápido del límite seleccionado durante toda la actualización, que cada elemento de A/B lo cruza una vez y que C se lee y se escribe una vez. Sea s el número de bytes por elemento, y contemos el trabajo principal de multiplicación-suma como dos operaciones. Entonces
Para k=b, I=b/(2s). Para k mucho mayor que b, I se aproxima a b/s. Son valores analíticos bajo las hipótesis declaradas de residencia y reutilización, no medidas de un dispositivo. En el caso cuadrado sencillo, mantener los tres bloques requiere al menos 3b² posiciones de entradas en el lado rápido; las disposiciones reales, los búferes y la asociatividad pueden exigir más.
Si β=0 y no es necesario leer la C anterior, el recuento ideal de datos baja a s(2bk+b²). Una política de asignación en escritura o una decisión de implementación aún puede generar tráfico. Si C sale de la memoria rápida entre actualizaciones de rango uno, su contribución cambia de nuevo. Contabilizar cuatro transferencias de elementos por cada actualización escalar supone que no existe reutilización efectiva en esa interfaz; no es un modelo genérico para cualquier bucle «ingenuo». Identificar el límite y la reutilización es necesario para que la intensidad aritmética tenga un significado definido.
El empaquetado añade otro conjunto de lecturas y escrituras, pero puede eliminar accesos repetidos y mal alineados dentro de una fase de cómputo mucho mayor. Su utilidad depende de la amortización. Un panel empaquetado que se reutiliza en muchos bloques de salida puede compensar su coste de construcción; una operación muy pequeña o de dimensiones muy estrechas puede no hacerlo. Un modelo completo contabiliza el empaquetado en cada interfaz pertinente, en lugar de suponer que es gratuito o siempre perjudicial.
Las cotas inferiores de comunicación no desaparecen al reducir los productos
Ballard, Demmel, Holtz y Schwartz analizan la comunicación para grafos de cómputo de tipo Strassen 29. Para una memoria rápida secuencial de M palabras, M≤n², y sin recomputación, su cota inferior para Strassen incluye
Es una cota inferior de movimiento de palabras bajo las hipótesis del grafo y de la memoria, no una predicción de tiempo de ejecución ni una afirmación universal para cualquier algoritmo con el mismo exponente. Su extensión a otros esquemas bilineales recursivos de base fija incluye una condición de conectividad del grafo de decodificación base. No puede extenderse al algoritmo óptimo desconocido simplemente sustituyendo log₂7 por ω.
La distinción importa al razonar sobre un algoritmo aritmético nuevo. Menos productos pueden reducir el trabajo, pero un grafo diferente puede cambiar cuánta memoria rápida se necesita para evitar recargar resultados intermedios. Recalcular un valor intercambia operaciones por comunicación y viola una hipótesis de ausencia de recomputación si se utiliza dentro de un argumento que la presupone. La distribución en paralelo añade restricciones adicionales; dividir una cota secuencial por el número de núcleos no produce, por sí solo, un teorema paralelo válido.
En una máquina real hay que medir las transferencias, no solo los tamaños de los arreglos asignados. Un temporal puede permanecer en caché, ser desalojado repetidamente o desaparecer mediante fusión. El espacio ocupado por una estructura de datos no es su tráfico total. Del mismo modo, la utilización del ancho de banda no identifica por sí sola el progreso útil: mover temporales innecesarios de forma repetida puede saturar una interfaz de memoria y, a la vez, producir un rendimiento bajo de la aplicación.
Strassen frente a GEMM optimizado de tipo BLAS/BLIS
La referencia práctica suele ser un GEMM optimizado, no tres bucles sin optimizar. El análisis de Goto y van de Geijn destaca el movimiento de memoria por niveles, el empaquetado, la elección del kernel interno y la cobertura de la TLB 28. BLIS separa la coordinación portable de un microkernel específico de la arquitectura 27. Elegir las dimensiones de los bloques de caché es distinto de elegir un bloque de registros.
Un microkernel mantiene un bloque de salida mᵣ×nᵣ en registros mientras consume fragmentos empaquetados de los operandos. Su demanda de acumuladores crece con mᵣnᵣ. Los bloques mayores mejoran la reutilización, pero consumen más registros y dejan menos espacio para vectores de operandos, punteros y planificación de instrucciones. En un modelo esquemático de contabilización de registros escalares,
Los recuentos reales dependen del ancho vectorial, la clase de registros, el tipo de datos y la forma de la instrucción. Un derrame de registros provocado por el compilador cambia el tráfico en un límite mucho más cercano que DRAM. Por tanto, elegir un bloque únicamente por la capacidad de caché omite una restricción que puede dominar el kernel.
Strassen no tiene por qué asignar todas las sumas algebraicas como matrices globales independientes. Strassen’s Algorithm Reloaded estudia su integración con una organización de tipo BLIS 31. Su enfoque AB incorpora las combinaciones de entrada al empaquetado; su enfoque ABC también integra las actualizaciones de salida en el microkernel y evita búferes temporales adicionales más allá de los búferes de empaquetado que ya utiliza GEMM. Es una transformación concreta del movimiento de datos, no la eliminación de toda memoria de trabajo.
Esta integración cambia el coeficiente b del modelo del umbral de rentabilidad. Si el empaquetado ya visita un operando, formar una suma necesaria durante esa visita puede evitar una pasada independiente. Si una salida intermedia puede acumularse directamente en sus destinos, puede desaparecer un par de escritura/lectura de un temporal. La dependencia algebraica sigue existiendo; la fusión cambia dónde se materializa. El solapamiento entre las salidas, la semántica de β y la propiedad de los datos por parte de los hilos deben seguir siendo correctos.
Los experimentos de SC16 muestran casos útiles de Strassen optimizado para formas y configuraciones especificadas. Refutan la afirmación general de que nunca es práctico. No establecen una profundidad de recursión universalmente ganadora ni superioridad sobre cualquier biblioteca optimizada en cualquier máquina. Una comparación responsable identifica la variante, la forma, el tipo de datos, el hardware, la afinidad de los hilos, la memoria de trabajo, el objetivo de precisión y el alcance de la medida de tiempo.
Otra métrica requiere cuidado. Un informe puede utilizar GFLOP/s efectivos, dividiendo el recuento clásico principal 2mnk por el tiempo transcurrido. Si el algoritmo ejecuta menos operaciones, esa tasa es un rendimiento equivalente para la aplicación, no los FLOP reales del hardware. Puede superar un pico aritmético sin violar la física porque el numerador es un recuento de trabajo de referencia. El rendimiento de operaciones reales y el rendimiento efectivo responden a preguntas distintas y deben etiquetarse como tales.
En inferencia, el «rendimiento de GEMM» también puede ocultar costes circundantes: transposiciones, descuantización, disposición de las activaciones, agrupación en lotes y asignación de tensores. Un kernel aislado más rápido no garantiza una solicitud más rápida. A la inversa, un kernel que ejecuta más aritmética puede mejorar la latencia al fusionar pasadas de memoria circundantes. El alcance de evaluación útil es el pertinente para la carga de trabajo, conservando medidas aisladas que permitan explicar el mecanismo.
RISC-V, memorias scratchpad y multiplicación de matrices de bajo consumo
Un sistema de memoria gestionado explícitamente hace visible el coste del movimiento de datos. Una memoria scratchpad no retiene automáticamente el bloque adecuado como podría hacerlo una caché transparente; el software elige la ubicación, la granularidad de las transferencias y la propiedad de los datos. Eso puede permitir una reutilización predecible, pero también convierte la capacidad, la planificación de DMA y la sincronización en parte de la corrección.
El nombre del conjunto de instrucciones no identifica por sí solo un modelo de rendimiento. Dos sistemas RISC-V pueden tener extensiones vectoriales, memorias locales, motores DMA, políticas de caché y rendimientos aritméticos diferentes. Un kernel optimizado debe dirigirse al procesador y a la cadena de herramientas reales. Una afirmación genérica de que un algoritmo es «rápido en RISC-V» oculta la mayoría de las variables necesarias para evaluarlo.
En un microkernel entero, la disposición de datos y la representación aritmética interactúan. Los datos empaquetados deben ajustarse a la agrupación y a la alineación de operandos que consume la secuencia de instrucciones implementada. Una organización de producto interno completa una salida escalar a lo largo de k; una organización de producto externo actualiza varias salidas utilizando fragmentos de operandos reutilizables. Cualquiera de las dos puede ser adecuada, pero difieren en su comportamiento de registros y transferencias. El recuento aritmético por sí solo no permite elegir entre ambas.
Solapamiento de DMA como extensión analítica
Supongamos que transferir un bloque tarda tload y que su cómputo tarda tcompute. Una planificación en serie tiene
Con dos búferes, recursos que operen realmente en paralelo y dependencias correctas, una segmentación ideal en régimen estacionario se aproxima a
El arranque, el vaciado, la sincronización, las escrituras y el empaquetado son términos adicionales. La desigualdad es una cota inferior del periodo alcanzable por bloque bajo el modelo idealizado, no un resultado medido de solapamiento. Si la transferencia y el cómputo compiten por el mismo banco o la misma interconexión, incluso el modelo del máximo puede resultar optimista. El doble búfer también duplica la asignación de los búferes correspondientes y puede obligar a utilizar bloques menores.
La corrección exige un ciclo de vida: un búfer se está llenando, otro se está consumiendo y ninguno puede sobrescribirse mientras un motor DMA o un núcleo conserve su uso exclusivo. Un evento de finalización no equivale a encolar una transferencia. Las actualizaciones de salida compartidas necesitan su propio esquema de propiedad. Una planificación rápida que lea ocasionalmente un panel incompleto no es una optimización.
Un modelo energético puede ser igualmente explícito sin inventar mediciones:
Los coeficientes deben caracterizarse para el dispositivo, el límite de memoria y el punto de funcionamiento. Reducir la aritmética puede ahorrar energía, pero las transferencias adicionales o un tiempo de ejecución mayor pueden compensar ese ahorro. Los distintos niveles de memoria necesitan coeficientes de transferencia diferentes. Esta expresión es un marco de modelado, no un resultado energético de GAP8 ni de ningún otro dispositivo.
La relación con mi investigación publicada
Mi artículo con Adrián Castelló y Enrique S. Quintana-Ortí, A BLIS-like matrix multiplication for machine learning in the RISC-V ISA-based GAP8 processor, estudia la organización de GEMM entero y la ubicación en memoria en GAP8 32. El trabajo adapta ideas inspiradas en BLIS a una arquitectura con recursos limitados, incluida la relación entre la ubicación de los operandos, el empaquetado y las transferencias. Es una contribución a la implementación y a la ingeniería de rendimiento, no una afirmación de mejora de ω.
La distinción entre la evidencia del artículo y las extensiones propuestas es importante. Los experimentos publicados se realizan en el Fabric Controller. El SDK simulaba la operación de producto escalar vectorial; una función auxiliar no demuestra que se ejecutara una instrucción SIMD de hardware. La ejecución en el clúster y la comunicación solapada se identifican como trabajo futuro. Por ello, el modelo de doble búfer anterior es una extensión analítica, no una característica ni una medición nueva atribuida a aquella implementación histórica.
El vínculo conceptual con la teoría es la elección del modelo de coste. La complejidad algebraica pregunta cuántos productos exactos bastan. El trabajo sobre GAP8 pregunta cómo organizar un producto especificado cuando el suministro de operandos y la capacidad de memoria son limitantes. Ambos requieren una descomposición y un argumento de contabilización, pero sus funciones objetivo son diferentes. Tratar uno como sustituto del otro restaría importancia al problema real de ingeniería.
Para los detalles de implementación, véanse el proyecto de investigación y el artículo más extenso de ingeniería de GEMM. La página de publicaciones proporciona el registro de investigación asociado.
Preguntas matemáticas y de ingeniería abiertas
El exponente sigue siendo una cuestión sobre la mejor construcción asintótica exacta posible, no sobre el mejor kernel que puede ejecutarse actualmente. Incluso si un resultado propuesto de 9/4 obtiene plena aceptación, no identifica el exponente verdadero ni cierra la distancia hasta dos. Del mismo modo, que un análisis láser concreto no pueda alcanzar un objetivo no descarta otra fuente tensorial, otro separador u otro marco algebraico.
Varias preguntas merecen respuestas separadas. ¿Puede una fuente o un teorema de extracción más potente reducir el exponente y mantener describible la construcción finita? ¿Pueden controlarse el tamaño de los coeficientes, el grado de degeneración y la dependencia de ε lo suficiente como para obtener una complejidad en bits significativa? ¿Puede relacionarse de forma transparente un teorema formal con el modelo aritmético legible por personas y con el artefacto fuente que realmente se comprueba? ¿Pueden implementaciones independientes reproducir el certificado sin compartir las mismas hipótesis o los mismos errores?
Para los algoritmos numéricos, las preguntas abarcan el error en norma y por componentes, los requisitos de precisión, el desbordamiento y el comportamiento de las combinaciones recursivas con precisión mixta. Una identidad exacta finita es solo el punto de partida. Una biblioteca útil necesita un contrato numérico, un tratamiento robusto de las formas y una política fiable de selección de algoritmos. La profundidad de recursión óptima puede depender de la tolerancia de error además de la máquina.
En arquitectura, el problema abierto de optimización es multiobjetivo. La aritmética, el tráfico, la memoria de trabajo, la latencia, el paralelismo y la energía interactúan. Un exponente mejor puede abaratar la aritmética respecto al movimiento de datos y aumentar la importancia de la comunicación. Un bloque mayor en registros puede mejorar la reutilización hasta que se produzca un derrame. Una segmentación de transferencias puede reducir las esperas hasta que sus búferes adicionales reduzcan el tamaño del bloque de cómputo. Son restricciones acopladas, no casillas independientes.
Por último, la reproducibilidad debe vincular cada resultado anunciado con su evidencia. Un exponente necesita un teorema con versión identificada y un modelo. Un certificado numérico de cota superior necesita factibilidad exacta y redondeo dirigido. Una afirmación formal necesita una especificación, un cierre de dependencias e instrucciones de reproducción. Una afirmación de rendimiento necesita código, carga de trabajo, hardware, precisión y un alcance de medida. Los criterios difieren porque las afirmaciones son distintas; hacer visibles esos criterios forma parte de la comunicación de la investigación.
Conclusiones
La historia comienza con una identidad de cancelación concreta y se amplía hasta convertirse en una teoría sobre lo que contienen las grandes potencias tensoriales. El rango proporciona un recurso aritmético finito; el rango frontera introduce construcciones límite; la desigualdad asintótica de la suma valora productos simultáneos; los métodos láser convierten la compatibilidad combinatoria en cotas del exponente. Las potencias superiores, la extracción refinada y la asimetría mejoran lo que puede demostrarse a partir de esa estructura. Los trabajos difundidos en 2026 introducen tanto afirmaciones de optimización más fuertes como una vía distinta basada en separadores y perfiles, cuyos argumentos, artefactos y estado de publicación deben evaluarse por separado.
La historia de ingeniería sigue un camino relacionado, pero distinto: hacer que la aritmética útil consuma operandos al ritmo al que la máquina puede suministrarlos. El empaquetado, el bloqueo en registros, la ubicación en memoria, la reducción de comunicación, la aritmética estable y la planificación de DMA determinan si una idea algebraica se convierte en una implementación práctica. Mi investigación sobre GAP8 pertenece a esa frontera de implementación. Comprender ambas fronteras exige explicar no solo qué ahorra una cota, sino también qué deja por resolver su modelo de coste.
Referencias
Los títulos científicos originales se conservan en ambos idiomas. Los manuscritos de los autores y los preprints con versión identificada que se enlazan especifican el material examinado; los DOI de publicación identifican el registro académico. Se señalan el alcance y las limitaciones de acceso cuando afectan a la exposición.
- , Gaussian Elimination is not Optimal, Numerische Mathematik, vol. 13, pp. 354–356, 1969. doi: 10.1007/BF02165411. Manuscrito.
- , Strassen's Algorithm Is Not Optimal: Trilinear Technique of Aggregating, Uniting and Canceling for Constructing Fast Algorithms for Matrix Operations, 19th Annual Symposium on Foundations of Computer Science (FOCS), pp. 166–176, 1978. doi: 10.1109/SFCS.1978.34. No se examinó la demostración original completa en esta revisión.
- , New Fast Algorithms for Matrix Operations, SIAM Journal on Computing, vol. 9, no. 2, pp. 321–342, 1980. doi: 10.1137/0209027. Se examinó el resumen editorial; este trabajo es distinto del artículo de congreso de 1978.
- , complexity for approximate matrix multiplication, Information Processing Letters, vol. 8, no. 5, pp. 234–235, 1979. doi: 10.1016/0020-0190(79)90113-3.
- , Relations between exact and approximate bilinear algorithms. Applications, Calcolo, vol. 17, pp. 87–97, 1980. doi: 10.1007/BF02575865. Se examinó el resumen editorial; no se examinó la demostración completa de interpolación.
- , Partial and Total Matrix Multiplication, SIAM Journal on Computing, vol. 10, no. 3, pp. 434–455, 1981. doi: 10.1137/0210032. Se examinó el resumen editorial; no se examinó la demostración original completa.
- , Some Properties of Disjoint Sums of Tensors Related to Matrix Multiplication, SIAM Journal on Computing, vol. 11, no. 2, pp. 263–267, 1982. doi: 10.1137/0211020. Año de publicación en revista; la cronología de la tesis utiliza 1981. Se examinó el resumen editorial, pero no la demostración completa.
- , On the Asymptotic Complexity of Matrix Multiplication, SIAM Journal on Computing, vol. 11, no. 3, pp. 472–492, 1982. doi: 10.1137/0211038. Versión en revista del trabajo de FOCS 1981. Se examinó el resumen editorial, pero no la demostración completa.
- , The Asymptotic Spectrum of Tensors and the Exponent of Matrix Multiplication, 27th Annual Symposium on Foundations of Computer Science (FOCS), pp. 49–54, 1986. doi: 10.1109/SFCS.1986.52. No se examinó la demostración original del congreso; sí se examinó la reconstrucción de Coppersmith–Winograd de 1990.
- , Matrix Multiplication via Arithmetic Progressions, Journal of Symbolic Computation, vol. 9, no. 3, pp. 251–280, 1990. doi: 10.1016/S0747-7171(08)80013-2. Manuscrito.
- , On the Complexity of Matrix Multiplication, PhD thesis, University of Edinburgh, 2010. Manuscrito. La mejora se publicó posteriormente con A. M. Davie en 2013.
- , Improved bound for complexity of matrix multiplication, Proceedings of the Royal Society of Edinburgh Section A: Mathematics, vol. 143, no. 2, pp. 351–369, 2013. doi: 10.1017/S0308210511001648. Manuscrito. Publicación de la mejora atribuida a la tesis de Stothers de 2010, no una reducción posterior independiente.
- , Multiplying matrices faster than Coppersmith-Winograd, 44th Annual ACM Symposium on Theory of Computing (STOC), pp. 887–898, 2012. doi: 10.1145/2213977.2214056. El decimal principal de la versión de congreso se corrigió en el manuscrito de la autora de 2014.
- , Multiplying matrices in time, Corrected author manuscript, 1 July, 2014. Manuscrito. Corrige el resultado del congreso a una cota del exponente inferior a 2.372873.
- , Powers of Tensors and Fast Matrix Multiplication, International Symposium on Symbolic and Algebraic Computation (ISSAC), pp. 296–303, 2014. doi: 10.1145/2608628.2608664. arXiv:1401.7714v1. Manuscrito.
- , A Refined Laser Method and Faster Matrix Multiplication, ACM–SIAM Symposium on Discrete Algorithms (SODA), pp. 522–539, 2021. doi: 10.1137/1.9781611976465.32. arXiv:2010.05846v1. Manuscrito. Anunciado inicialmente en octubre de 2020; versión posterior en TheoretiCS, vol. 3, artículo 21, 2024.
- , Faster Matrix Multiplication via Asymmetric Hashing, 64th IEEE Annual Symposium on Foundations of Computer Science (FOCS), pp. 2129–2138, 2023. doi: 10.1109/FOCS57990.2023.00130. arXiv:2210.10173v4. Manuscrito. Anunciado inicialmente en 2022; la cota 2.371866 aparece en la revisión de abril de 2023.
- , New Bounds for Matrix Multiplication: from Alpha to Omega, ACM–SIAM Symposium on Discrete Algorithms (SODA), pp. 3792–3835, 2024. doi: 10.1137/1.9781611977912.134. arXiv:2307.07970v1. Manuscrito. Anunciado inicialmente en julio de 2023; la cota cuadrada publicada no es estricta: omega <= 2.371552.
- , More Asymmetry Yields Faster Matrix Multiplication, ACM–SIAM Symposium on Discrete Algorithms (SODA), pp. 2005–2039, 2025. doi: 10.1137/1.9781611978322.63. arXiv:2404.16349v1. Manuscrito. Anunciado inicialmente en abril de 2024. La cota histórica 2.371339 corresponde a las versiones iniciales y a las actas; una revisión de 2026 incorpora una optimización posterior.
- , Improving the matrix multiplication exponent with modern optimization and AlphaEvolve, arXiv:2608.16884v1, 17 August, 2026. arXiv:2608.16884v1. Manuscrito. Preprint. Esta revisión no estableció una publicación con revisión por pares ni reprodujo de forma independiente el certificado.
- , A faster matrix multiplication algorithm through structured optimization, arXiv:2610.10593v1, 6 October, 2026. arXiv:2610.10593v1. Manuscrito. Preprint con un certificado racional exacto; la disponibilidad del verificador es distinta de una formalización completa o de una reproducción independiente de la demostración.
- , An Upper Bound of 9/4 for the Matrix Multiplication Exponent, Official research release, 2 October, 2026. Manuscrito. Publicación de investigación fijada a una revisión, con artefactos de demostración formal; aquí no se establece revisión por pares ni una ejecución local completa de Lean.
- , Complex Matrix Multiplication Below 2.258 and Rectangular Bounds, Official research release, 24 September, 2026. Manuscrito. Publicación de investigación fijada a una revisión. La integridad de los archivos, la reproducción numérica finita y el argumento matemático completo tienen alcances de verificación distintos; ninguno se ejecutó en esta revisión.
- , Polynomial Separation of a Shared Tensor Leg and Matrix Multiplication in Arbitrary Characteristic, arXiv:2610.18914v1, 12 October, 2026. arXiv:2610.18914v1. Manuscrito. Preprint independiente de seguimiento matemático; esta revisión no estableció una publicación con revisión por pares.
- , Matrix Multiplication from Polynomial Packings: A Constructive Proof of , arXiv:2610.28627v2, 30 October, 2026. arXiv:2610.28627v2. Manuscrito. Título mostrado en el manuscrito v2; los metadatos de la página del resumen conservan la redacción más larga. Preprint independiente de seguimiento, no una revisión por pares establecida.
- , Roofline: An Insightful Visual Performance Model for Multicore Architectures, Communications of the ACM, vol. 52, no. 4, pp. 65–76, 2009. doi: 10.1145/1498765.1498785. Manuscrito.
- , BLIS: A Framework for Rapidly Instantiating BLAS Functionality, ACM Transactions on Mathematical Software, vol. 41, no. 3, Article 14, 33 pages, 2015. doi: 10.1145/2764454. Manuscrito.
- , Anatomy of High-Performance Matrix Multiplication, ACM Transactions on Mathematical Software, vol. 34, no. 3, Article 12, 25 pages, 2008. doi: 10.1145/1356052.1356053. Manuscrito.
- , Graph Expansion and Communication Costs of Fast Matrix Multiplication, Journal of the ACM, vol. 59, no. 6, Article 32, 23 pages, 2012. doi: 10.1145/2395116.2395121. arXiv:1109.1693. Manuscrito. Versión en revista; los registros anteriores de SPAA y arXiv datan de 2011.
- , Fast matrix multiplication is stable, Numerische Mathematik, vol. 106, no. 2, pp. 199–224, 2007. doi: 10.1007/s00211-007-0061-6. arXiv:math/0603207. Manuscrito. El preprint final data de 2006; la propiedad de estabilidad declarada es una cota de error directo en norma, sujeta a sus hipótesis.
- , Strassen's Algorithm Reloaded, International Conference for High Performance Computing, Networking, Storage and Analysis (SC16), pp. 690–701, 2016. doi: 10.1109/SC.2016.58. Manuscrito.
- , A BLIS-like matrix multiplication for machine learning in the RISC-V ISA-based GAP8 processor, The Journal of Supercomputing, vol. 78, pp. 18051–18060, 2022. doi: 10.1007/s11227-022-04581-6.
- , RISC-V Low-Power Processors: Enhancing Matrix Computations and Deep Learning Convolution Algorithms, PhD thesis, Universitat Politècnica de València, 2025. El autor proporcionó las imágenes del apéndice C. Se conservan los metadatos bibliográficos existentes; el registro institucional no fue accesible de forma independiente durante esta revisión.